setup.ini-methode
Nicht jede Setuproutine unterstützt das einlesen einer setup.ini. in der Regel findet man dies heraus, indem man „<programmname> setup.ini“ googelt. Neben dieser möglichkeit verüfgen die setup-dateien oftmals über den Kommandozeilenparamter -s oder /s, der ebenfalls eine unattended-installation erlaubt. Dazu muss man einfach „Programmname unattended installation“ googlen. Man kann es natürlich auch aauf gut Glück versuchen. Führt man die setup.exe aus, so bedient sich diese den Einstellungen aus der setup.ini und ist dann in der Lage zur automatisierten Installation.
Oft reicht es dabei nicht, einfach eine setup.ini zu erstellen. Viele Suchmaschinen-Suchergebnisse werdem einem folgendes vorschlagen:
- Neben der gewönhlichen Setup.exe im Hauptordner gibt es meist einen sogenannten administrativen installationspfad auf dem installationsmedium, dieser ist meist der Unterordner Setup auf dem installationsmedium, dort liegt dann eine sogenannte administrative setup.exe mit mehr möglichkeiten als die gewönhliche, welche in der wurzel des Mediums liegt. Hierbei müssen Sie recherchieren, ob dies für Sie zutrifft.
- Diese administrative Setup-Datei hat oftmals paramteroptionen wie etwa /createunattended <\dateipfad\für\eine\ini-Datei>. Somit können Sie eine grafische Installation der software vornehmen und aus dieser wird dann eine .ini-Datei erstellt, die Sie für künftige Installationsvorgänge auf kommandozeilenebene verwenden können
- in unserem administrativen Installationsordner wird desweiterne eine Datei namens setup.sdb aktualisiert. Diese enthält meist den Lizenzkey für das Produkt. Das beudeutet, dass bei der Installation die setup.sdb aus diesem adminsitrativen Setup-Ordner gelesen wird, um automatisch den Lizenzoey einzufügen.
- Neben dem LicenseKey, der automatisch in die setup.sdb geschrieben wird, muss man noch die Produkt-ID mittels eintrag prodID darüber schreiben. Die beiden Einträge müssen per Zeilenumbruch getrennt werden
ImageType=NET ProdID={<ID} LicenseKey=<Key> - will man nun die unattended-installation ausführen, so darf man auch hier nicht die normale .setup-Datei im root des instalationsmedium ausführen, sondern muss die administrative Setup-Datei mit der option setup.exe /unattendfile x:\Pfad\zu\setup\setup.ini
Setup.exe / update.exe /s
Der Windows install Shield stellt Entwicklern die option bereit, ihre Software mit InstallScript bzw. InstallScript MSI zu erstellen. Diese wiederum haben die option, eine installation im sogenannten Silent Mode laufen zu lassen, der mit dem Schalter /s aktiviert wird. Dadurch wird für dieInstallation keine grafische Oberfläche gestartet und die installation also auf Kommandozeilenebene durchgeführt. Wenn man dann noch die benötigten installationsparameter per kommandozeile übergibt, beispielsweise den Lizenzkey und den Installationspfad, dann bedeutet dies, dass man die installation automatisieren kann. Man findet, ob eine installationsroutine dies untersützt, indem man „Programmname InstallScript options“, „Progrmamname setup.exe comamnd Line“, „Programmname Silen installation“, „Programmanem unattended installation“, oder „Programmname setup.exe /s“ sucht.
auch bei dieser Variante lohnt es sich, im installationsmedium nach einer administrativne setup.exe zu suchen, die sich möglciherwiese in einem unterordner setup befindet.
Um ein InstallSript MSi oder installSrioptm projekt installatiosnprogrmam im Silent modus aufzurufen, müssen wir erst die Setup.ee mit der option /r aufrufen, um ähnlich der setup.ini-Methode durch eine vorangehende installation ein Antwortfile zu erstellen, welches sich die getätigten einstellungen merkt. Die einstellungen werden dann in einer Datei namens setup.iss gespeichert. Diese wird in der Regel im windows-Ordner gespeichert, wir können aber einen alternativne Speicherort mit der option /f1 angeben.
Basic MSI Projekte verwendne hingegen kein Response-File für silent installationen
Danach könenn wir mit setup.exe /s die installation im silenmodus durchführen. Dabei sollten wir unser Antwortfile setup.iss im selben Verzeichnis wie die administrative Setup.exe haben, ansonsten müssen wir wieder einen alternativen Ort über die Option /f1 angeben.
Um ein Basic MSI Produkt im Silent-mode auszuführen, müssen wir hingegen Setup.exe /s /v/qn eingeben. Basic MSI produkte haben kein Response-File und brauchen daher Paramter in der form von Setup.exe /s/v“/qnINSTALLDIR=“D:\Destination“
Wie Sie der Überschrift schon entnehmen können, können Sie bei einigen Produkten nicht nur die Installation, sondern auch das Updaten der Software mit dem Silent-Schalter übernehmen. Hierzu gibt es oft eine update.exe im Verzeichnis der Programminstallation.
Kopieren und Registry einträge nachziehen
Wenn ihre Software weder die setup.ini-Methode noch die Unattended-Installation unterstützt, kann es gegebenenfalls helfen, eine normale Installation durchzuführen und sich einfach nur die Dateien im Programmordner wegzukopieren. Zusätzlich suchen Sie im Registry-Editor (Start / Ausführen / regedit) nach Schlüsseln mit dem Namen des Programms oder des Herstellers, vor allem im Pfad HKEY_LOCAL_MACHINE\Software, und exportieren sich die Schlüssel in .reg-Dateien. Sie können dann versuchen, den Programmordner auf Kommandozeilenebene auf das Zielsystem zu kopieren und dort dann die .reg-Dateien auszuführen, sodass die Registrierungsschlüssel in die registry des zielsystems geschrieben werden. Bei überraschend vielen Softwareinstallationen klappt dies problemlos. Probleme bekommen sie nur, wenn bei der Softwareinstallation auch Dateien an andere Stellen des Systems kopiert werden, beispielsweise in das Windows-Verzeichnis. Hierzu müssen Sie halt nur feststellen, in welche Ordner sonst noch bei der nistallation Dateien kopiert werden. Dazu können sie sich einem Tool bedienen, welches Ihre Ordner nach Dateiänderungen überwacht. Starten Sie das Tool, lassen sie verdächtige Ordner wie C:\Program Files, C:\Windows usw. überwachen und führen Sie die installation durch. Nach der installation haben Sie eine Übersicht, welche Dateien geändert wurden. Entsprechende tools wären beispielsweise
- DirectoryMonitor
- TheFolderspy
- Track Folder changes
- Watch 4 Folder
- FolderchangesView (empfohlen)
- windows Explroer Tracker
- Spy-The-Spy
- SpyMe Tools
- Disk Pulse
- file Alert monitor
Automatisches Entpacken
Alternativ zu der Methode, dass Sie die Installationsdateien einfach per Copy und Paste auf Kommandozeilenebene kopieren, können Sie sich auch eine Archivdatei basteln, welche die Dateien beim Entpacken automatisch in die richtigen Ordner verschiebt. Damit können Sie beispielsweise nicht nur Softwareinstallationen automatisieren, sondern auch andere Dateien ausrollen, die beispielsweise jeder mitarbeiter in Ihrem Unternehmen auf seinem Arbeitsplatz braucht.
Bevor wir uns ein solches Archiv erstellen, möchte ich Ihnen nur kurz zeigen, wie Sie auf Kommandozeilenebene verschiedene Packerarchive extrahieren.
sie extrahieren .7z-Archive über
<Pfad zur 7z.exe> e <Pfad zum .7z-Archiv>
.rar-ARchive extrahieren Sie mit installiertem WinRar über
<Pfad zur UnRAR.exe>  x "<Pfad zur .rar-Datei>" <Pfad zum Zielordner>

#passowrtgeschützte Datei

<Pfad zur UnRAR.exe> x -p<Passwort> "<Pfad zur .rar-Datei>" <Pfad zum Zeilordner>
normale .zip-Dateien können Sie ebenfalls mit WinRaR extrahieren – jedoch nicht mit der unRAR.exe, sondern mit dre winrar.exe.
<Pfad zur winrar.exe> x <Pfad zur .zip-Datei> <Zielordner>
Nun erkläre ich Ihnen das Erstellen eines selbstextrahierenden Archivs mit WinRAr. Starten Sie WinRar und fügen sie die zu archivierenden installationsdateien zu einem neuen Archiv hinzu. im reiter Advanced wählen Sie die SFX options. im neuen Fenster wählen Sie im Reiter General den Zielordner, in den die Softare installiert werden soll. Es amcht Sinn, im reiter Mdoes den Silent mode auf Hide all zu setzen, damit während des Entpackvorgangs kein Fenster geöfnfnet wird und die Aktion für den User transparent bleibt. Im reiter Files können Sie nachträglich noch Dateien zum Archiv hinzufügen.
Automatische Installation über .msi-Archive
Bei allen Softwareinstallationen, für die Sie die Dateien und Zielpfade kennen, können Sie die Installation auch über ein .msi-Archiv automatisieren. Der vorteil ist, Sie können hier einige Dateien in den rpogrammordner verschieben und einige Dateien in andere Ordner, wie beispielsweise den Windows-Ordner, den Desktop oder den Eigene-Dateien-Ordner des zielsystems. Und: diese Art von .msi-Installation lässt sich über Gruppenrichtlinien im Microsoft Active Directory ausrollen.
Eine sehr einfache Möglichkeit ist das tool MSI Wrapper (altnerative: EMCO MSI Package Builder). Sie starten das Programm, und wählen die setup.exe des programms, dessen Installationsroutine Sie in eine .msi-Datei packen wollen. Das programm muss bereits auf dem Rechner, auf dem Sie die .msi-Datei erstellen, installiert sein, weil Sie die Application ID des Programms aus einer Liste auswählen müssen. Erstellen Sie einen neuen Upgrade Key. Die Registry-Einträge, die gesetzt werden müssen, werden automatisch von den Registry-Einträgen, die sich auf Ihrem PC befinden, eingelesen (sofern das Programm bereits installiert ist). Im fenster Parameters geben Sie dann noch unter Install Arguemtns und Uninstall Arguments jeweils /S ein, um die installation und Deinstallation im Silent-modus abzuschließen. Zum Schluss bauen Sie die .msi-Datei. Diese können Sie beispielsweise einfach über Active Directory Gruppenrichtlinien ausrollen lassen.
Eine fortgeschrittene Möglichkeit ist das Tool Advanced Installer. Das Toolist Free, solange sie im New Project-Menü das Basic-template verwenden. speichern Sie die Projektdatei mit Endung .aip irgendwo, den Output-Folder und den Namen der .exe oder .msi-Datei. als nächstes wählen Sei den Ordner mit den installationsdateien. Wichtig ist für Sie nachher das Menü Ressources / Files and Folders sowie Resources / registry. Dort wählen Sie, welche Dateien in welche Ordner und welche Registry-Keys gesetzt werden sollen.
eigene und fremde .msi-Pakete können Sie auf Kommandozeilenebene einfach foglendermaßen silent installieren.
msiexec.exe /qn /i <pfad zur .msi-Datei>
Sollte die option /i nicht funktionieren, rpioberen sie die Option /x
msiexec.exe /qn /x <Pfad zur .msi-Datei>
Eventuell müssen Sie bei fremden .MSI-Dateien zusätzliche Optionen wie etwa einen Produktcode angeben. Einen Prpoduktcode geben Sie meist folgendermaßen an
msiexec.exe /qn /x {<code>}
andere Optionen können Sie mit dem Orca Tool ausspähen und dann folgendermaßen angeben
msiexec.exe /qn /[i|x] <Parametername>=<Wert>
Wenn dir dieser Post gefallen hat, teile ihn doch auf Social Media, abonniere und verfolge mich per E-Mail, RSS-Feed, Social Media oder registriere dich auf meiner Seite. Wenn du registriert bist, like den Post bitte, wenn er dir gefallen hat!]]>
Die häufigste Art, sich auf einem Oracle-System zu authentifizieren, ist die sogenannte local authentication. Hierbei werden die Zugangsdaten der Oracle DBMS-User im Oracle Data Dictionary gespeichert, also beispielsweise Passwörter, biometrische Daten o. Ä.
In größeren Unternehmen ist es jedoch gängig, sich an der Oracle datnebank über LDAP anzumelden. Hierbei können sich Benutzer über ihre Microsoft Active Directory- oder OpenLDAP-Accounts anmelden und dann über verschiedene Privilegien, die wir weiter unten kennenlernen werden, die Identität von Administratorkonten wie SYS annehmen.
Ein Datenbankparameter, den Sie wahrscheinlich niemals in Ihrer gesamten Oracle-Karriere aktivieren wollen, ist der Parameter REMOTE_OS_AUTHENT und OS_AUTHENT_PREFIX.
Die Passwörter einiger Nutzer sollten Sie sofort nach der Oracle-Installation ändern
- SYSTEM (Intialpasswort MANAGER) und SYS (Initialpasswort CHANGE_ON_INSTALL).
- Benutzer DBSANMP dient zur Überwachugn der Isntanz über das SNMP. Falls Sie kein SNMP einsetzen, können Sie den nutzer auch einfach sperren (siehe weiter unten)
- Benutzer scott. Ein übungsuser, der zugriff auf eine Übungsdatenbank hat. In dieser übungsdatenbank könnten Angreifer beispielsweise Schrottdateien einfügen und somit den Speicherplatz vollschreiben. Scott ist bei neueren Oracle.Versionen jedoch standardmäßig gesperrt.
Benutzerverwaltung
Benutzer sperren
Benutzer können sie folgendermaßen sperren.
alter user <username> account lock
Privilegien
Bei Priviligen unterscheidet man zwischen
- Systemprivilegien. Sien enthalten REchte auf alle bojetke eines bestimmten Typs udn generelle Rechte im System wie etwa Verbinden und Anmelden
- objektprivilegien enthalten REchte auf bestimmte Objekte
Privilegien eignen sich zur Vergabe an einen konkreten, bestimmten User. in der Praxis jedoch vergibt amnd ie selben privilegien häufig an mehrere Nutzer, weshalb in der Praxis später Rolleng ebaut werden, die den jeweiligen nutzern dann einfach zugewiesen werden.
Einer der drei großen Pfeiler der IT-Security ist das Accounting. Es bedeutet, dass jederzeit nachvollziehbar sein muss, welche Person welche administrativen Tätigkeiten auf dem System ausgeführt hat.
dies können Sie aber nicht gewährleisten, wenn die Administration von SAP-Systemen mt den standardmäßig erstellten Administrationsusern arbeiten.
- SYS – SYS ist sozusagen der Superuser, das Administratorkonto des Oracle DBMS. SYS ist dabei nicht nur der Superuser mit Administratorrechten, sondern auch der Besitzer des SYSTEM-TAblespace und anderer systemrelevanter Tablespaces, Tabellen und Views wie etwa dem Data Dictionary. Dadurch kann dieser User auch Änderungen am System selbst vornehmen.
- SYSTEM – ein etwas weniger machtvoller Account. Der User System besitzt nicht wichtige Objekte wie das Data Dictionary und kann beispieslweise kein backup udn recovery oder datenbankupgrade durchführen.
- SYSMAN
Für bestimmte Tätigkeiten brauchen Sei die Rechte des SYS Nutzers, weil Sie beispeislweise Datenbankparameter abändern müssen. Diese Rechte hat eben nur der SYS Nutzer, da nur der SYS-Nutzer Egientümer des SYSTEM-Tablespaces ist und daher nur dieser Nutzer die Datenbankparameter abändern kann. Wenn Sie sich jedoch direkt als SYS-Nutzer an der Datenbank anmelden, haben Sie wiederum das problem, dass Sie nicht nachvollziehen können, welche Person mit dem SYS-Nutzer gearbeitet und daher die Änderungen vollzogen hat.
Um dieses Problem zu adressieren, gibt es das sysdba-Privileg. Sie können in einer Oracle-Instanz Single Sign on einrichten, so dass sich beispielsweise Windows Nutzer über Active Directory oder Linux Nutzer über LDAP an der Oracle Instanz anmelden können. Wenn Sie diesen nutzern oracle-intern die Rolle SYSDBA geben, dann ist es möglich, dass sich diese Nutzer anmelden und danach ein Kommando ausführen, welches dazu führt, dass Sie zum Nutzer SYS werden. Das kommando wird in den Logs der Oracle-Instanz aufgezeichnet udn somit kann im Nachhinein nachvollzogen werden, wer sich wann als User SYS angemeldet hat.
Als erstes müssen Sie einen neuen User erstellen
create user <name> identified by <passwort>
Eventuell wollt ihr für bestimmte Tablespaces eine quota erstellen, so dass der user einen tablespace beispielsweis enicht voll schreiben kann
SQL>CREATE USER <name> profile "defaulT" identified by "<passwort>" default tablespace "users" temporary tablespace "TEMP" quota 100 M on "users" account unlock

SQL>grant "connect" to "<username>"
Eine wichtige sicherheitseinstellung ist, dass der Stndardtablespace, auf den sich User einloggen, NICHT der SYSTEM-Tablespace ist.
Zu diesem User können wir außerdem ein Profil erstellen, welches bestimmte Beschränkungen setzt, beispielsweise wie viel CPU-Power pro SEssion der User bekommt, wann sein Passwort ausläuft, wie komplex sein Passwort sein muss und wei oft ein falsches Passwort eingegbeen werden kann, bevor der Account gesperrt wird.
CREATE PROFILE "<Profilname>" LIMIT CPU_PER_SESSION DEFAULT CPU_PER_CALL DEFUALT CONNECT_TIME DEFAULT IDLE_TIME DEFAULT SESSIONS_PER_USER 1 LOGICAL_READS_PER_SESSION DEFAULT LOGICAL_READS_PER_CALL DEFAULT PRIVATE_SGA DEFAULT GOMPOSITE LIMIT DEFUALT PASSWORD_LIFE_TIME 30 PASSWORD_GRACE_TIME 30 PASSWORD_REUSE_MAX UNLIMITED PASSWORD_REUSE_TIME DEFAULT PASSWORD_LOCK_TIME UNLIMITED FAILED_LOGIN_ATTEMPTS 6 PASSWORD_VERIFY_FUNCTION DEFAULT
Dieses Priofil könnenw ri jetzt dem frisch erstellten User zuweisen.
ALTER USER "<username>" PROFILE "<profilname>"
initial könnt ihr auch jedem neuen User bereits beim erstellen ein Profil zuweisen
CREATE USER "<username>" PROFILE "<profilname>" IDENTIFIED BY "<passwort>" PASSWORD EXPIRE ACCOUNT UNLOCK GRANT "<privileg>" TO "<username>"
Wenn ihr eine Passwort-Komplexität erzwingen wollt, müsst ihr ein extra skript namens utlpwdmg.sql ausführen. Es befindet sich unter ORACLE_HOME\RDBMS\ADMIN\. Führt das Skript aus und von nun an funktioniert eine erzwungene password_complexity.
Nun stellt sich noch die Frage, welche privilegien doer rollen der Useraccount bekommen soll. Es gibt zwei spezielle Privieligen
- SYSDBA. Nach seinem Login führt der user das kommando aus, um zum user SYS zu werden und dann auf der Datenbank alles zu tun,a lso Parameter ändern, updaten, backup und Recovery, Oracle isntanz starten und stoppen, Zugriff zu ALLEN Daten. Es wird geloggt, welcher User sich wann über seinen Useraccount zum user SYS gemacht hat, was den Anforderungen der IT-Security-Grundsäule Accounting gerecht wird.
- SYSOPER. Nach seinem Login führt der user das Kommando aus, um zum User PUBLIC zu werden. Der user kann nur backupen, Oracle-Isntanz starten udn stoppen. Der User kann nicht updaten und hat keinen Zugriff auf Daten. Es wird geloggt, welcher User sich wann über seinen Useraccount zum user PUBLIC gemacht hat, was den Anforderungen der IT-Security-Grundsäule Accounting gerecht wird.
Wenn wir jetzt beispielsweise wollen, dass unser user das Privileg SYSDBA bekommt, geht das über
grant SYSDBA to "<username>";
Statt solcher „Userwechsel“-Privilegien können Sie auch SQL-Privilegien an einen User vergeben.
grant select on <objekt> to <username>;

grant create table on <objekt< to <username>;
Sie werden jedoch sehr schenll merken, dass das äußerst mühsam ist. Stattdessen sollten Sei solche Privilegien über Rollen regeln, die Sie dann dem einzelnen User zuweisen.
Es ist jedoch sehr schmerzhaft, Rollen über SQL zu erstellen. DAs sollten Sie wirklich über den Oralce Enterprise Manager machen, da Sie dann nicht sämtliche Privilegien auswendig wissenj müssen, die Sie eventuell in die Rolle packen wollen.
Hier für interessierte jedoch trotzdem der Weg zum Bau einer rolle über SQL
create role <rollenname>
Nun, da Sie die Rolle definiert haben, müssen Sei noch festlegen, welche Rechte in dieser rolle enthalten sein sollen. DAs geschieht etwa in folgendem Format, wenn sie festlegen wollen, welche Spalten eienr Tabelle die Rolle abfragen können soll:
grant select (<spalte1>, <spalte2>, <spalte3>) on <tabellennname> to <rollenname>
nachdem Sie die Berechtigungen für diese Rolle definiert haben, weisen Sie die Rolle noch verschiedenen Nutzern zu
grant <rollenname> to <username1>

grant <rollenname> to <username2>
Sioe können eine Rolle jedoch auch in eine andere Rolle verschachteln, so dass die eine Rolle in der anderen Rolle enthalten ist.
grant <rollenname1> to <rollenname2>

grant <rollenname2> to <username>
Sie könenn eien Rolle natürlich auch wieder von einem user entfernen
revoke <rollenname> from <username>
Wichtige privilegien sind beispielsweise
- create session. Das Recht, sich an de rdatenbank anzumelden
- create any table. Das recht, eine Tabelle anzulegen
- drop any table … with admin option. Recht, tabellen oder Datensätze zu löschen und das Recht weiterzugeben
- update (<spaltenname>) on <tabellenname>. Das Recht, die Werte von <spaltenname> in Datensäzen der Tabelle <tabellenname> zu ändern.
Oracle liefert bereits einige vordefinierte Rollen mit
- CONNECT. Enthält das Recht, sich am System anzumelden
- RESOOURCe. Enthlt REchte zum Anlegen von objekten und wird im Enterprise Manager genauer aufgeschlsüselt
- DBA. ist das Recht, adminsitrativen Zugriff auf Datenbankobjekte auszuüben.
die Rollen des angemeldetne Benutzers können Sie sich folgendermaßen anzeigen lassen
select username, granted_role, admin_option from user_role_privs;
und die Default_Rollen folgendermaßen
select granted_role from user_role_privs where default_role= 'YES';
die aktiven Rollen füpr die aktuelle Sessions des Nutzers erhalten sie über
select * form session_roles;
Objektprivilegien des Nzutzers bekommen Sie über
select table_name, privilege, grantable from user_tab_privs
Jetzt noch ein kleiner Sonderfall. Nehmen wir einmal an, sie müssen an der Oracle-Instanz eine Wartung vornehmen, die es erfordert, dass die datenbank selbst nicht gemountet wird. Man würde die Instanz also im nomount-state starten lassen. Da das Passwrot für ihren User aber in der Datenbank gespeichert wird, können Sie in diesem Nomount-Stae standardmäßig nicht mit ihrem user an der Oracle-Instanz arbeiten, da Sie sich ohne gemountete Datenbank nicht anmelden können. Die Lösung kommt mit einem sogenannten Pw-File. Diese Datei speichert das Passwort in einer gehashten Binärdatei, das Passwort ist also nicht im Klartext lesbar. Das File befindet isch stnadardmäßig unter %ORACLE_HOME%\database oder %ORACLE_HOME%\dbs und heißt PWD<SID>.ora. Damit diese Atuhentifzierung funktioniert, muss der Parameter REMOTE_LOGIN_PASSWORDFILE gesetzt sein. Zur Erstellung der apsswortdatei wird dann das Tool ORAPWD genutzt. Der Oracle Database Configuration Assistnat führt das ORAPWD-Tool autoamtisch aus, wenn über den DBCA eine Datenbank erstellt wird.
Grundsätzlich ist die Möglichkeit des Logins über ein Passwortfile jedcoh ein mögliches sicherheitsleck, da es anderen nutzern erlaubt, sich über das netzwerk mit SYSDBA- oder SYSOPER-Rechten anzumelden.
alter database default_tablespace users;
Ein Privileg, auf welches Sie besonders Acht geben müssen, sit das PUBLIC-Privileg. Das Pjublic-privileg wird automatisch jedem user zugeteilt, der das Connect-Privileg hat, sich also auf dem System anmelden kann. Es gibt einige Releases der Oralce Database, bei welcher das PUBLIC-Privileg wiederum das EXECUTE-Recht beinhaltet, also das Recht, PL/SQL-Code auszuführen.
wir können schauen, auf wie welche PL/SQL-Pakete das Public-Privileg derzeit Zugriff erteilt, über
select table_name from dba_tab_privs where grantee = 'PUBLIC' and privilege = 'EXECUTE' and table_name like 'UTL%'
Es gibt in oracle ein paaar sehr sensitive PL/SQL Pakete, auf die Sie unbedingt Acht geben sollten
- UTL_FILE – Zugriff auf Betriebssystem und Dateisystem
- UTL_TCP – Öffne TCP Ports
- UTL_SMTP – E-Mail-Versand
- UTL_HTTP: Web browsen
sie können auf solche delikaten Pakete den zugriff für das Public-privileg widerrufen, indem Sie folgende Befehle ausführen
revoke execute on utl_file from public

revoke execute on utl_tcp from public

revoke execute on utl_smtp from public

revoke execute on utl_http from public
Auditing
Um Auditing zu aktivieren müssen wir den Datenbankaprameter AUDIT_TRAIL setzen, also das Verzeichnis, in welcehs Audit-Informationen gespecihert werden sollen. Dieser Parameter kann nur bearbeitet werden, wenn die Instanz heruntergefahren ist.
Nachdem diese raprmeater gesetzt ist, können wri festlegen, was wir auditen wollen, etwa
audit select any table by access

audit select any table by session
Der Unterschied zwiscehn den beiden Optionen by access und by session ist, dass bei der by-access-Option jeder einzelne Zugriff auf Tabellen geloggt wird
Wenn der Parameter audit_trail auf DB gestzt ist, können Sie das Audit eines Benutzeraccounts einsehen über
select sql_text, priv_used, action_name from dba_audit_trail where username='<username>'
Auch wenn der Parameter audit_trail auf DB gesetzt ist, findet ihr unter Windows im Ereignis Log Einträge über Auditing-Events in Oracle.
Wenn dir dieser Post gefallen hat, teile ihn doch auf Social Media, abonniere und verfolge mich per E-Mail, RSS-Feed, Social Media oder registriere dich auf meiner Seite. Wenn du registriert bist, like den Post bitte, wenn er dir gefallen hat!]]>
Ein Listener ist ein Service, der auf einem bestimmten Socket nach eingehenden Verbindungen horcht. Wenn sie auf Ihrem Server nur eine IP-Adresse haben, haben Sie meist nur einen Listener. Wenn Sie jedoch mehrere Netzwerkkarten und somit mehrere IP-Adressen auf dem Server haben, um eine höhere Ausfallsicherheit zu gewährleisten, würden Sie für jede Adresse einen extra Listener konfigurieren.
Listener starten, stoppen und Status abfragen
lsnrctl start <listenername>

lsnrctl status <listenername>

lsnrctl stop <listenername>
konfigurieren können Sie Listener entweder über den oracle Net cofniguration Assistant oder über die Datei %ORACLE_HOME%\NETWORK\ADMIN\listener.ora
Listener Services anzegien
Wir können uns alle Services anzeigen lassen, mit denen ein Listener verbunden ist
lsnrctl services
Listener konfigurieren
ihr könnt den Lsitener einmal über den oracle net Manager über Oralc enet configuraiton / Local / Listeners konfigurieren.
Als allerletzten Ausweg können Sie die Datei %ORACLE_HOME%\network\admin\listener.ora mit einem Texteditor bearbeiten, um den Listener zu konfigurieren.
Hinweis: wenn Sie die Oracle-Datenbank für ein SAP-System betreiben, befindet sich die Datei listener.ora unter \\sapmnt\<SAPSID>\SYS\profile\oracle, sofern die umgebungsvariable %TNS_ADMIN% gesetzt ist. ohne getzte TNS_ADMIN befindet sich die listener.ora wieder im Standardordner.
Listener absichern
Unter Oracle 9i und älter können Sie den listener folgendermaßen mit einem Passwort belegen
lsnrctl

LSNRCTL>change_password

Old passwort:

New password: <new password>

LSNRCTL> set password

passord: <neues Passswort>

LSNRCTL> save_config
Das passwort liegt dann in der listener.ora. mit 10g können Sie die Listener-kofngiruation über den Paramer ADMIN_RESTRICTIONS_LISTENER einstellen. Ist dieser parameter auf ein, wird geprüft, ob der benutzer Schreibrechtea uf die Datei listener.ora hat. Falls ja, erlaubt er einen Zugriff auf die Listener-Konfiguration.
tnsnames
auf Clientseite, also auf dem Rechner, von dem aus Sie auf die Oracle-Datenbank zugreifen (meistens der selbe Rechner), befindet sich eine Datei tnsnames.ora, welche die Verbindungsdatena uf Cleintseite konfiguriert, mit denen versucht wird, sich auf dei Oracle-instanz zu verbinden. Diese müssen natürlich identisch sein mit den Daten, die in der listener.ora auf serverseiitge konfiguriert worden sein, insbesondere
- die Community
- das Protokoll (meist TCP)
- die System-ID der oracle-Instanz
- und der Port (meist 1521 oder 1527)
Oracle Instanz
verbinden zu einer Instanz
Eine normale Verbindung zu einer laufenden Oracle-instanz machen Sie mit
sqlplus <username>/<passwort>@<DBSID>
Das funktioneirt antürlcih nur, wenn der roacle connection idnetifier in der datei tnsnames.ora entsprechend gesetzt wird.
Eine bessere Methode ist der sogenannte SYSDBA- oder SYSOPER-connect. Diese rerfolgt immer nur auf dem Datenbankserver selbst, also nicht auf einem fremden Host, der sich auf dei Datenbank verbnden möchte. eine Vebrindung von einem solchen fremden Host ist nur nach einer speziellen konfiguration möglihc.
hierbei authentifziert sich der Nutzer nicht büer Benutzernamen und APsswort, sondern anhand der zugehörigkeit zu einer Betriebssystemgruppe, die als Oracle-Datenbankadministratorgruppe gekennzeichent ist. Die Anemldugn erfolgt heirbei über das kommando
sqlplus / as sysdba

#bzw.

sqlplus / as sysoper
oracle prüft dann, ob der Betriebssystembenutzer zur Unix-gruppe dba bzw. zur Windows-Gruppe ORA_<DBSID>_DBA gehört bzw. ORA_<DBSID>_OPER.ist dies der fall, erhält der User ufmassende Rehcte und ist an der datnebank angemeldet.
Im Gegensatz zur Benutzername/Passwort-Anmeldugn weiter oben funktioniert diese Anmeldung auch, wenn die Oracle-Datenbank offline ist, da die Anmeldedaten somit nicht im Oracle Data Dictionary stehen. Somit kann man sich auch an einer Oracle-Instanz anmelden, die gestoppt ist, um sie beispielsweise neu durchzustarten.
als drittes Verfahren gibt es das sogenannte OPS$-Verfahren. hier muss es einen Oracle-Datenbankbenutzer namens OPS$<sid>adm geben, damit man sich als Betriebssystembenutzer <sid>adm an der Datenbank anmelden kann. Der Präfix OPS$ ist dabei nicht fix, sondern wird über die Umgebingsvariable os_authent_prefix bestimmt. Die Verbindung wird dann aufgebaut über
sqlplus /
Oralce sucht dann in der tabelle DBA_USERS nach einem OSP$-Benutzer. ist dieser vorhadnen, darf sich der Betriebssystembenutzer, der in dieses Schema passt, anmelden. Damit diese Art dder anmeldung auch von einem anderen Host funktioniert als auf dem, auf welchem die Oracle-Instanz läuft, msus die Umgebungsvairable remote_os_authent auf TRUE gesetzt sein.
die OPS$-Anmeldung funktioniert nur, wenn die Oracle-instanz online ist, da Informationen aus der Datenbank abgerufen werden müssen.
sie könenn alle OPS$-Benutzer einer Oracle-Instanz anzeigen lassen über
select USERNAME from DBA_USERS where USERNAME like 'OPS$%';
Einen OPS$-user können Sie ntsprechend so anlegen
cerate user "OPS$<OS-Username>" default tablespace <default_tablespace> temporary tablespace PSAPTEMP identified by externally;
welchen Status hat die datenbank?
Wenn sie nach dem Login über sqlplus die meldung bekommen
conntected to an idle instance
dann ist die Instanz gestoppt.
Wenn diese Meldung nicht kommen, läuft die Instanz. Um den Status der Datenbank abzufragen, führen Sei das SQL-Statement aus:
select status from v$instance;
Die Datenbank kann heirbei den Status nomount, mount oder open haben. Welche bedeutung der jeweilige Status hat, lernen Sie weiter unten.
Welche Version aht die datenbank?
select * from v$version;
instanz stoppen
Zum Stoppen einer instanz gibt es verschiedene Methoden
- Normal. Die instanz bleibt bestehen,d bis alle bestehenden Verbindungen geschlossen sind. Sauberste, aber langsamste Methode, um eine Datenbank herunterzufahren
- immediate. Killt alle bestehenden Verbindungen und rollt nicht durchgelaufene Transaktion einfach zurück
- Transactional. Killt alle Verbindungen ohne lafuende Transkationen. Verbindungen mitlafuenden Transaktionen werden jedoch laufen gelassen, bis diese Transaktionen durchgelaufen sind. Erst dann wird die Instanz beendet.
- Abort. Die dreckigste methode zum Stoppen. Kein Rollback und kein Beenden von Sessions, einfach „Strom aus“ sozusagen. Sollte wirklich die allerletzte Option sein, um die Datenbank-Instanz zu stoppen.
shutdown <Option>

#Beispiel

shutdown immediate
Alternativ können Sei die instanz unter Windows auch über die Oralce MMC stoppen, indem sie im Knoten Console Root / Oracle Managed objects / computers / <hostname> / datbases / <Datenbankname> rechtsklicken und dort den Kontextmenüpunkt Startup/shutdown options wählen.
Instanz starten
Es gibt verscheidene Modi, um eien Oracle-Instanz zu starten
- nomount. es wird nur die Instanz gestartet und der SGA-speichebreich wird zugeweisen und freigehalten.
- mount es wird außerdem anhand des control files inklusive redo logs gemountet, aber nicht geöffnet. Das heißt die Datenbank kann beispielsweise für ein Datenbank-Recovery genutzt, aber nicht beschrieben oder gelesenw erden.
- open. Die Datenbank wird zusätzlich geöffnet und kann produktiv genutzt werden.
Sie können eine Oracle-Datenbank entweder gleich in den einsatzbereiten Zustand bringen über
startup open
oder Schritt für Schritt, das ginge beispieslweise über
startup nomount

alter database mount;

alter database open;
Eine Weitere option ist startup force. startup force ist sozusagen ein sehr schneller, aber dreckiger neustart. startup force ist eine Kombination aus den beiden kommandos shutdown abort und startup open. Diesen Befehl soltlen Sie aber nur dann ausführen, wenn Sie sehr wenig Zeit haben.
Parameterwerte anzeigen
Wie Sie aus den theoretischen Grundlagen wissen, bedient sich eine Oracle-Instanz diverser Konfigurationsparameter, die sie entweder in der PFILE- oder in der SPFILE-Datei speichern können.
Es gibt verschiednee arten von Parametern
- static initialization parameter. Änderungen an diesem APremater greifen nur, wenn man nach der Änderung die Oracle-instanz neu startet
- dynamic initialization paremter. Änderungen an diesem Paramter greifen sofort, nachdem man ihn geändert hat und ie Oracle-instanz äluft
- Basic Parameter. Diese sind die 30 wichtigsten Parameter, die jeder DBA kennen sollte
- Advanced Parameter. sind abhängig von der Edition der Oracle Database, die installiert ist. sie sollten nur getweaked werden, wenn der oracle support oder der Support des Anwendungsssystems es empfiehlt.
Sie können scihd ie Werte von Parametern anzeigen lassen über
show parameter <parametername>;
Alternativ können Sie sich auch in den oracle enterprise Manager einloggen und dort im Menü navigieren nach Server / Database Configuration / initialzation Parameters. Dort können Sie dann in die Liste den Namen des Parameters eingeben und sich dessen Werte anzeigen lassen. In dem Bildschirm haben Sie zwei Regsiterakrten. Die Registerkarte Current zeigt Ihnen alle Parameter, die derzeit in der Arbeitsspeicherkopie des SPFILES gesetzt sind, und die Registerkarte SPFILE zeigt Ihnen die Parameter, die derzeit hart in das SPFILE auf der festplatte geschrieben sind.
Über die View V$PARAMETEr können Sie sich anzeigen lassen, welche Parameter statisch und welche dynamsich sind.
SQL>select ISSYS_MODIFIABLE, ISSSES_MODFIIABLE from V$PARAMETER where NAME='<Parametername>';
| ISSYS-MODIFIABLE | Erklärung |
| FALSE | Parameter ist statisch |
| IMMEDIATE | Parameter ist dynamisch |
| DEFERRED | Parameter ist dynamisch, Änderung wird aber nur für neue Sessions aktiv, nciht für alte. |
wenn die Spatle ISSES_MODIFIABLE auf FALSE steht, kann der Parameter nicht über eine einzelne Session gesetzt werden (siehe weiter unten).
Auch wenn Sei das SPFILE in eienm Texteditor ansehen können, sollten Sie im SPFIEL keien Änderungen vornehmen. Jede manuelle Änderung an der SPFILE-Datei führt dazu, dass diese nicht mehr gelesen werden kann.
Wenn die Paraemter desweiteren nicht über das SPFILE, sondern über das obsole PFILE im klartext gepflegt werden, können Sie das PFILE öffnen. Es nennt sich initOra<DBSID>.ora udn kann mit jedem beliebigen Texteditor geöffnet werden.
Parameter setzen
Wie Sie aus den theoretischen Grundlagen wissen, bedient sich eine Oracle-Instanz diverser Konfigurationsparameter, die sie entweder in der PFILE- oder in der SPFILE-Datei speichern können.
es gibt verschiedene Arten von Paraemtern
- normale Parameter bestimmten Egienschaften der datenbank
- underscore-Parameter beginnen mti einem Unterstrich. sie sind nur für notfälle gedacht und sollten nru auf explizite Anweisung von Oracle oder vom Hersteller der Anwendungssoftware gesetzt werden, die die oracle-Datenbank nutzt
- events sind flags, die das Verhalten der Datenbank verändern oder Trace-/Debug-informationen sammeln, wenn ein bestimmtes Ereignis eintritt. Acuh sie soltlen nur bei expliziter Empfehlung gesetzt werden.
Das PFILE ist eine Textdatei und kann daher mit einem gewöhnlcihen Texteditor bearbeitet werden. Das SPFILE ist eine Binärdatei und kann nur noch mti dem SQLPlus-Kommando ALTER SYSTEM SET geändert werden. DAs ist auch gleichzeitig die zu bevorzugende Methode, da hier die Syntax der gesetzten Parameter auf Fehler überprüft wird und das SPFILE im Gegensatz zum PFILE einige angesprochene Vorteile hat.
Es gibt zwei Instanzen des SPFILES: Einaml die Version, die auf der festplatte gespeichert wird und einmal das Abbidl des SPFILES im Arbeitsspeicher. Sie können einen Parameter nur temporär setzen, dann wird dieser nur auf die Arbeitsspeicherkopie des SPFILES angewandt und verschwindet wieder, sobald die Oracle-Instanz das nächste mal neu gestartet wird. das empfiehlt sich beispielsweise zum Testen neuer Parameter. Wenn Sie einen parameter hingegen auch beim Neustart der oracle-Instanz behalten wollen, müssen Sie ihn auch auf die Festplatte schreiben.
Das temporäre Setzen im Arbeitsspeicher geht über
alter system set <parameter>=<wert> scope=mem;
Das permanente setzen geht über
alter system set <parameter>=<wert>;

#oder die beiden Befehle

alter system set <parameter>=<wert> scope=mem;

alter system set <parameter>=<wert> scope=[pfile|spfile];
Eventuell haben Sie früher nur ein PFILE über den Texteditor konfuguriert und möchten Ihre Datenbankparameter nun in das empfehlenswertere SPFILE umziehen. Das geht über folgendes Kommando
CREATE SPFILE FROM PFILE;
umgekehrt können sie natürlich auch zurückkonvertieren.
CREATE PFILE FROM SPFILE;
Sie können überprüfen, ob die oracle instanz mit dem PFILE oder SPFILE startet über
select decode(value, NULL, 'PFILE', 'SPFILE')

"Init File Type"

FROM v$parameter

where name = 'spfile'

#oder

SQL>show parameter spfile
eine Besonderheit: Parameter, die mit einem Unterstrich beginnen, setzen Sie folgendermaßen (Beispiel):
alter system set "_ktb_debug_flags"=8
sogenannte FIX-Control Parameter setzen Sie so:
alter system set "_fix_control"='<bug_number>:ON|OFF'
Einen Parameter löschen/reseten können Sie über
alter system reset <parametername>
einen APrametr nur für die aktuelle Session setzen:
alter session set <Paramter>=<Wert>
Events setzen
alter system set events '<Nummer>';
Editor definieren
Es macht sinn, einen Editor für eure SQLPlus-Statements festzulegen.
für Windows nehmt ihr beispielsweise
define_editor=notepad

#oder

define_editor=wordpad
und für Linux etwas wie beispielsweise
define_editor=vi

#oder

define_editor=vim

#oder

define_editor=nano

#oder

define_editor=sublime

#oder

define_editor=emacs
nachdem ihr diesen Befehl eignebgen habt, könnt ihr den Befehl
SQL> edit
engeben und es öffnet sich der Editor mit dem aktuellen Buffer-Inhalt. ihr könnt mit dem Editor nun euer SQL-Statement speichern und sobald ihr den Editor schließt wird das SQL-Statement aktualisiert mit dem inhalt des Editors,d as könnt ihr prüfen mit
SQL>l
Theoretisch müsstet ihr den Befehl define_editor nach ejder sqlplus-Anmeldung eingeben. Damit das jedes mal automatisch passiert, könnt ihr die Datei ORACLe_HOME\sqlplus\admin\glogin.sql bearbeiten und dort den entsprechenden Befehl eingeben.
Den inhalt des Buffers könnt ihr nun ausführen lassen über
SQL>run

#oder

SQL>/
Pagesize ändern
Wenn ihr eine Query startet, werdet ihr manchmal feststellen, dass zusammengehörige Ergebnisse meist folgendermaßén abgetrennt werden
SPALTENNAME1

----------------

Wert1

Wert2

Wert3

Wert4


SPALTENNAME1

----------------

Wert5

Wert6

Wert7

WErt8
Der Grund ist, dass Oracle die Ergebnsiausgabe in mehrere Seiten unterteilt. Oracle denkt, dass ihr nach einer bestimmten Anzahl von Zeilen wieder erneut den Spaltennamen sehen wollt, damit ihr nicht hochscrollen und nachsehen müsst, welcher Spaltenname das nochmal war. Meistens ist dies jedoch eher störend und hinderlich als nützlich. Ihr könnt das abschalten, indem ihr die Pagesize auf 0 stellt, dann kommen die Spaltennamen nur einmal. Schreibt auch dazu den Befehl
set pagesize 0
in eure glogin.sql.
Linesize ändern
Wenn ihr merkt, dass viele Abfrageergbenisse ungünstig umbrochen werden, weil SQLPlus enien automatischen zeilenumbruch einfügt, könnt ihr dies unterbinden, indem ihr die Linesize ändert
set linesize 1000
Logdateien
Um zu sehen, ob sie derzeit vollgelaufende Redo-Logs archivieren, geben Sie ein
archive log list;
Um den Status Ihrer logfiles einzusehen, geben Sie ein
select * from v$logfile;

select * from v$log;
Kontrolldateien
Kontrolldateien multiplexen
erstmal prüfen, wo die Control Files derzeit liegen
SQL>show parameter control_files;
Ihnen wir nun ausgespuckt, wo die beiden control Files gehalten werden. Eventuell werdne sie ehrausfinden, dass beide control Files auf dem selben Datenträger leigen, das wollen sie natürlich nicht.
Um die cnotrol Files nun umzusetzen, müssen Sie erst die Datenbank runterfahren.
SQL>shutdown normal
Jetzt gehen Sie zum Standort der Control Fiels, normalerwiese %ORACLE_BASE%\oradata\orcl und verschieben eines der Control Files zu einem anderen Datenträger.
Jetzt müssen Sie den Standort des zweiten Control Files umsetzen. Dazu müssen Sie de Parameter control_files im PFILE InitOra<DBSID>.ora so abändern, dass der Pafad der zweiten Datei auf den neuen Standort zeigt.
Da die Datenbank-Instanz nicht up war, mussten wir den Parameter im PFILE setzen. Wenn ihre Oracle-insatnz jedoch so konfiguriert ist, dass sie die Datenbankparameter nicht vom klartext-PFILE, sondern vom binären SPFILE liest, müssen Sei den Parameter erst noch vom PFILE in das SPFILE bekommen. Das können Sie beispeislweise machen, indem sie sich an sqlplus anmelden
$>sqlplus / as sysdba
dann das SPFILE aus dem PFILE erstellen
SQL>create spfile from pfile;
jetzt können wir die Instanz komplett neu durchstarten
SQL>startup
Datendateien der Tablespaces sowie Kontrolldateien anzeigen
Der obere zeigt alle Tablespaces und deren Data Files an, der untere die kontrolldateien
select t.name, d.name, d.bytes from v$tablespace t join v$datafile d on t.ts# = d.ts# order by t.name
select * from v$controlfile;
Oracle Managed Files
Oracle Managed Files bedeutet, dass sich die Oracle-Instanz selbst darum kümmern, die Speicherorte und die Verwlatung der Betriebssystemdateien wie beispielsweise Datendateien, Control Files usw. zu übernehmen. Sie können jedoch weiterhin die Operationen durchführen, um diese autoamtisch gepflegten Dateien an ihre individuellen Bedürfnisse anzupassen.
Sie können prüfen, ob OMF derzeit angeschaltet ist, über
show parameter db_create
Wenn im Result keiner der Parameter mit einem Wert befüllt ist, ist OMF deaktiviert.
Anschalten über
alter system set db_create_file_dest='ORALCE_BASE\oradata\<DBSID>'
wenn Sie jetzt beispeislweise einen neuen TAbelsapce erstellen ohne einen Pfad für das Datafile anzugeben, wird unter dem oben angegeben Pfad automatisch eine neue .dbf-Datendatei erstellt.
Client
wenn von anderen Rechnern als dem System, auf dem die Oracle-Isntanz läuft, auf die instanz zugegriffen werden soll, muss die Oralce Client-Software heruntergeladen und installiert werden.
Tablespaces und Datendateien
Zunächst einmal gilt es die Frage zu beantworten, warum man denn überhaupt potentiell eigene Tablespaces erstellen möchte, schließlich bringt Oracle ja bereits vordefinierte Tablespaces mit, in denen man die Daten speichern könnte. Mögliche Gründe sind etwa
- Organisation. Wenn es mehrere Tablespaces gibt, kann es sein, dass nur einer der tablespaces ansteigt und sich bei vielen anderen die Dateninhalte nicht ndern. Das führt dazu, dass man seine Backupskripte etwa so schreiben kann, dass Tabelsapecs nur gebackupt werden, wenn sich die Datafiles geändert haben. Wenn man mehrere Tablespaces hat, muss nicht immer die gesamte Datenbank gebackupt werden, sondern nur der Tablesapce, der sich seit dem letzten Backup geändert hat. Das verringert die Zeit und die Performance, die ein Backup in Anspruch nimmt.
- Performance. Sie können unterschiedliche Tablespaces auf unterschiedlichen Datenträgern abspeichern lassen, um die Schreib-/Lesegeschwindigkeit beider datenträger nutzen zu können.
- sicherheit und Verwaltung. Man kann zu Tablespaces Quotas zuweisen, die bestimmte Beschränkungen zuweisen.
Beim Anlegen eines Tablespaces muss man entscheiden, ob ein temporärer oder permanenter Tablespace erstellt werden muss. temporäre Tablespaces haben eigentlich nur sinn, wenn man einen vorübergehnden arbeitsplatz braucht, auf dem man Daten zwsicehnspeichern kann.
Dann muss man noch entscheiden, ob man den Tablesapace als beschreibbar (r/w) oder als read only (r/o) erstellen möchte. Letzteres macht beispieslweise sinn für Archivierungs-Tabelspaces.
Es gibt desweiteren verschiedene Tablespace-typen
| Typ | Extent-Verwaltung | Inhalt | Allokationsverwaltung | Segmentverwaltung |
| 1 | Dictionary | Permanent | USER | MANUAL |
| 2 | Dictionary | temporär | USER | MANUAL |
| 3 | LMTS | Pemranent | SYSTEM(autoÄ) / UNIFORM | MANUAL |
| 4 | LMTS | pmeranent | SYSTEM(auto)/UNIFORM | AUTO |
| 5 | LMTS | temporär | UNIFORM | MANUAL |
Tablespace-Typ prüfen
SQL>select tablespace_name, extent_management, allocation_type, segment_space_management from dba_tablespaces;
Tablespace erstellen
CREATE SMALLFILE TABLESPACE "<tablespacename>" DATFILE '/pfad/zum/datafile.dbf' SIZE 100M

LOGGING

EXTENT MANAGEMENT LOCAL

SEGMENT SPACE MANAGEMENT AUTO
Tablespace offline / online nehmen
einen Tablesapce offline zu nehmen kann beispielsweise sinnvoll sein, wenn der tablesapce nur ein Archiv sein soll und nur sehr sehr selten abgefragt wird.
Einen Tablespace kann man unter anderem über den Enterprise Manager offline nehmen. Wählen Sie den betreffenden Tablesapce aus, gehen Sie auf Edit und wählen Sie bei Status den Status Offline aus und klicken auf Apply.
Tablespace Größe vergrößern
Das geht einmal über den Oracle Enterprise manager. einfach den entsprechenden Tabelspace ausählen und auf Edit gehen. Ihr könnt im darauffolgenden Fenster nun entweder ein Data File auswählen und auf Edit gehen und dort die Fil e Size hoch stellen, oder einfach ein neues Data File hinzufügen. Nach dieser Änderung dann im Enterprise Manager noch Apply drücken, um die Änderungen wirksam zu machen.
Alternativ kann man Datafiles folgendermaßen vergrößern
ALTER DATABASE DATAFILE '/pfad/zum/datafile.dbf' RESIZE <xxx>M;
Ein neues Datafile fügen Sie folgendermaßen hinzu.
ALTER TABLESPACE "<tablespacename>" ADD DATAFILE '/pfad/zum/neuen/datafile.dbf' SIZE 600M;
Man kann auch Autoextend anschalten, damit die Datafiles sich autoamtisch vergrößern, wenn sie volllaufen. Der folgende Befehl vergörßert ein volles Datafile immer um 20 MegaByte.
ALTER DATABASE DATAFILE '/pfad/zum/datafile.dbf' AUTOEXTEND ON NEXT 20M
den Status der Tablespaces fragen Sie folgendermaßen ab
select * from v$tablespace;
Ist z. B. nützlich, wenn man ein Backup auf das Datafile gestartet hat und das Backup nicht beendet wurde, also der tablespace nicht in aus dem Backup-status zurückversetzt wurde.
TAblespace-status abfragen
select * from v$tablespace;
Datendateien-Status abfragen
select * from v$datafile;
Tablespace umbenennen
alter tablespace <alter Name> rename to <neuer name>
Reorganisation
Bei der reorgnaistiaon werden Tabellen neu organisiert, also von Grund auf neu erstellt und verschoben. Der Hauptgrund für eine Reorganisation ist die rückgewinnung von Festplattenspeicher, wenn es beispieslweise viele nicht ganz vollgeschriebene Extents gibt, da einige Datensätze aus den TAbellen gelöscht wurden, oder durhcd ei simple Reduzierung der Größe von Datendateien, wenn diese nach einer Archivierung nicht mehr so groß sein müssen. Ein weiterer Grund könnt die Umstellung des Tablespace-Typs, oder nach einer migration / nach einem Datenbank-Upgrade, falls sich technologische Ansätze in der neuen Datnebank unterscheiden.
Bei einer Online-Reorganisation werden die Segmente innerhalb der datnebank vershcoben, ohne dass es heirbei zu Locks kommt. Man kann also weiterhin auf die Objekte in der Datenbank zugreifen und mit ihr arbieten. Bei einer Offline-Reorganisation wird das Objekt jedocha us der datnebank exportier,t gelöscht und dann wieder neu importiert. DEer anchteil bei einer Online-Reorganisation ist, dass alle zu reorganisierten bojekte während der reorganiastion zweimal vorhanden sein müssen, was einen hohen platzbefdarf ausmacht.
Alerting
Das Oracle AlterLog leigt unter ORACLE_BASE\diag\rdbms\dbname\<dbsid>\trace\alert_<DBSID>.log
Das Log liegt im .xml-Format vor.
Das Oracle Atuoamtic diagnostic Repository liegt in dem parameter DIAGNOSTIC_DEST. Meistens liegen wichtige Alerts unter ORACLE_BASE\dia\rdbms\orcl\orcl\alert sowie ORACLE_BASE\dia\rdbms\orcl\orcl\trace.
Sie finden Alert messages außerdem im enterprise Manager unter Home, wenn Sei anch unten scrollen bis zum Alerts-Punkt.
Sie können acuh in sqlplus das diagnostic repository abfragen.
select * from v$diag_info
User Management
Eigentlich sollte es äußerst selten vorkommen, dass Sie als DBA irgendwas mit Usern zu tun haben werden. Denn meistens läuft die Datenbank ja als Datenhaltungskomponenten für einen anwendungsserver, der seine eigene Userverwaltung mitbringt und selbst immer den selben Datenbankuser benutzt, um mit der Datenbank zu kommunizieren. Dennoch schadet es nicht, sich mit den Tätigkeiten auseinander zu setzen.
Alle User anzeigen, die online sind.
select username, account_status from dba_users where account_status like 'OPEN%';
den Status der useraccounts anzeigen, z. B. ob ihr konto expired & locked ist
select * from dba_users;
Netzwerkkonfiguration
Im Dedidacted Server Mode bekommt jeder User einen eigenen Hintergrundprozess mit einem PGA-Speicherbereich. Im Shared Server mode gibt es nur einen einzigen Prozess und es laufen alle User-Environments nicht in enem extra PGA-Bereich, sondern alle User-Environments liegen im SGA.
Vorteile an Shared:
Nachteile an Shared:
- der Oracle RMAN braucht dedizierte Verbindungen pro User, die ja im shared User Modus fehlen.
tnsnames
tnsnames.ora ist eine Datei, welche die Verbindungseinstellungen für das SQL*Plus Skript auf Clientseite konfiguriert. das heißt diese Datei konfiguriert die verbindungen des Kommandozeilentools SQL*Plus, mit dem wir uns auf eine Oracle-Instanz aufschalten können. Die Einstellungen in dieser Datei sind im klartext beschrieben und können auch mit einem Texteditor gesetzt werden. die einfache Möglichkeit diese einstellungen zu setzen ist aber der oracle Network Configuration Assistant.
EZ Connect
EZ Connect is tein roacle-eigenes produkt, nach dessen installation man sich sehr einfach auf eine Oracle-Instanz verbinden kann
CONNECT username/<pw>@<hostname>:<port>/<dbname>
SQL-Skripte
Man kann vordefinierte SQL-Befehle in einer .sql-Datei abspeichern und diese dann über sql-plus so ausführen, als würde man sie gerade hintereinander über die Tastatur eingeben.
Zum ausführen von .sql-Skripten geben Sie ein
@<Pfad zur .sql-Datei>
Optimizer Statistics
Die Statistiken des Optimizers werden vom oralce Query Optimizer genutzt, um Ablaufpläne für SQL-Queries zu optimieren, so dass der optimalste ablaufplan für verschiedene SQL-Operationen genutzt wird. Es empfiehlt sich also aus perofrmancegründen, den optimizer zu pflegen.
ein wesentlicher Datenbankparameter für die Statisitiken ist der APrmeter STATISTICS_LEVEL. Dieser steht standardmäßig auf TYPICAL.
Um Statistiken über objekte zu sammeln, führen wir beispielsweise einen Befehl aus wie
analyze table <user>.<tabelle> compute statistics;
Jetzt haben wir statistische Werte über diese Tabelle gesammelt. Beispielsweise können wri uns jetzt die Anzahl der Datensätze / Zeilen in dieser tabelle anzeigen lassen über
select num_rows from dba_tables where table_name='<TABELLE>';
Da jetzt über diese Tabelle ständig die Anzahl der Datensätze verfügbar ist, kann Oracle besser entscheiden, welchen Ausführungsplan es verwenden soll,w enn auf diese Tabelle beispielsweise ein SELECt-Statement ausgeführt wird. Wenn ein neuer Datensatz in die Tabelle eingefügt wird, werden die Statistiken leider nicht gleich autoamtishc aktualsiiert.
execute dbms_stats.gather_table_stats('<username>'.'<tabelle>');)
Erst jetzt ist die Anzahl der Datensätze aktualisiert.
Diese Gathering-Methode sollte nun regelmäßig ausgefüjhrt werden, damit die Statistiken ohne unser Zutun automatisch aktualsieirt werden. Das geschieht über einen Atuaomted maintenance Task frü das optimizer Statistiscs gathering.
Automatic workload Repository AWR MMON, Baselines und Snapshots udn ADDM
Mit dem Automatic Wrokload repository können wir Snapshots oderBaselines erstellen. Snapshots sind Statistiken der Oracle-Instanz zu einem bestimmten Zeitpuinkt. Diese Statistiken entahtlen beispielsweise die aktuelle Wartezeit auf eien Atnwort zu einen SQL-Befehl, die Nutzung von CPU und Arbeitsspeicher durchd ie Oracle-Instanz, den Speicherverbrauch und die Größe der einzlenen Caches im Arbeitsspeicher der Oracle-Isntanz usw.
Eine Baseline ist ein paar von Snapshots, welches der Administrator als „NOrmalwert“ ausgewählt hat. Das bedeutet diese beiden Snapshots zeigen an, wie sich die Oracle Datenbank normalerweise im Zeitraum zwischen zwei Snapshots verhält. Es ist möglich, alle zukünftigen Snapshots dieser Baseline gegenüberzustellen, um daraufhin zu erkennen, welche Werte sich im Vergleich zur Baseline verschlechtert bzw. verbessert haben. Mit den Snapshots des AWRs ist es also möglich, perofrmanceanalysen über die Oralce-Instanz zu machen.
wir wollen jetzt mal eine AWR Baseline erstellen
exec dbms_workload_repository.create_snapshot;
Im Enterprise Manager können wri einen Snapshot erstellen über Server / Staitsitsc amnagement /( automatic workload Repository / Snapshots / Create.
Das AWR ist sozusagen der Statistiklieferant einer Oracle-Instanz. Wenn der AWR das Messgerät ist, dann ist der ADDM der Doktor der Oracle-Instanz. Der ADDM nimmt einen Snapshot aus dem AWR und führt automatische Analysen durch. Beispielsweise sucht er nach Verantwortlichen SQL-Statements, die für eine möglciherweise hohe Auslastung der Oracle-Instanz verantwortlich sind, und gibt Vorschläge für ein sauberes Memory Sizing für die Oracle-Instanz.
Oracle Scheduler
Der Oracle Scheduler ermöglicht es uns, verschiedene Wartungsaufgaben zu automatisieren und für verschiedene Zeitpunkte zu planen.
MMOn
MMON ist zuständig für die alarmierung.
Der erste Task, um Warnungen und Alerts auch per E-Mail zu empfangen, sit Oracle auf einen SMTP-Server zu verweisen. DAs geht im Oralce enterprise Manager rechts oben über Setup / Notification methods. Hier können wir dann die Daten des SMTP-Servers hinterlegen.
Indexes
einen index erstellen
Ein Index wird für eine Tabelle erstellen, also msus zuerst eine Tabelle erstellt sein, auf die der Index aufbaut. Danach kann man den index erstellen über
create index test_index on <tabellenname>(<spaltenname primärschlüssel>);
Wenn ein Index invalid ist und repariert werden muss
select objecT_name, object_type from dba_objects where status = 'INVALID';
Indexes neu bauen
alter index <name> rebuild;
Views
Zum erstellen einer View brauchen wir natürlich erstmal eine Tabelle. Views sidn ja, wie wir aus dem Theorieteil bereits wissen, nichts anderes, als abgespeicherte SQL-Statements. Deswegen müssen Sie auch das SQL-Statement parat haben, mit der Sie die View erstellen wollen. DAnach können Sie die Viwe erstellen über
create view <name> as <SQL-Statement>;
Wenn eine View invalid ist und repariert werden muss
select objecT_name, object_type from dba_objects where status = 'INVALID';
Views reparieren
alter view <name> compile;
Procedures
euine Prozedur kann man erstellen über
create procedure <name> as

begin

<Code>

end;
Wenn eine Procedure invalid ist und repariert werden muss
select objecT_name, object_type from dba_objects where status = 'INVALID';
Procedurs reparieren
alter procedure nl_add_emp compile;
Oracle Patchen
Es gibt zwei verschiedene Arten von Patches
- interm. Ein Hotfix, der oft auf eine sehr spezielle Version von Oracle zugeschnitten ist, also meistens nicht auf eine weite Reichweite von Oracle-Versionen anwendbar ist. Behebt meistens nur eines oder wenige Probleme. Die Hotfixes werden meistens nicht voll getestet udn können ab und zu auch zu Fehlern führen, weshalb nach dem anwendnen eines Hotfixes erst getetstet werden sollte, bevor man ihn auf das produktivsystem anwendet.
- Ciritical Patch Update (CPU): werden alle drei Monate released, können auf eine weite Reichweite von verschiedenen Oracle-Versionen angewendet werden und adressieren viele Probleme.
Zunächst können Sie einen Patch Advisor ausführen. Dieser führt vorher einige Abhängigkeitschecks durch um sicherzustellen, dass das System dazu in der Lage ist, den Patch überhaupt anzunehmen.
Sie könne den Patch Advisor über den Oralce Enteprrise manager mittels software and Support / aptch Advisor ausführen. Dies funktioniert natürlcih nur, wenn Sie ienen Oracle Supportvertrag abgeschlossen haben und daher Support von Oracle bekommen.
Patchen mit gleichbleibendem Oracle Home
Als erstes invoken wir Opatch mit
cd ORACLE_HOME\OPatch

SQL>opatch lsinventory
Wir wenden den APtch an
SQL>opatch <Pfad zur Patchdatei>
sie könen einen APtch auch über den ROacle Enterprise Manager über Software and Supportt / Apply Patch anwnenden.
Characterset
Den aktuellen Cahraceterset einer Datenbank kann man folgendermaßen überprüfen
select VALUE from V$NLS_PARAMETERS where PARAMETER='NLS_CHARACTERSET';
Bei Non-Unicode SAP-Systemen unter einer Oracle Datenbank Version 8 oder neuer wird immer WE8DEC eingesetzt, auf einem unicode-System wird immer UTF8 verwendet.
Troubleshooting
Die erste Maßnahme ist immer
tnsping <servicename bzw. dbname>
dies testet die verbindung auf die Oracle instanz / DB und zeigt einige Parameter an.
Wenn dir dieser Post gefallen hat, teile ihn doch auf Social Media, abonniere und verfolge mich per E-Mail, RSS-Feed, Social Media oder registriere dich auf meiner Seite. Wenn du registriert bist, like den Post bitte, wenn er dir gefallen hat!]]>
Erstellen von Datenbanken
manuell
Bevor man eine Oracle-Datenbank erstellt, sollte man zuvor die Größe der Datenbank, die Anzahl der tablespaces und die Redo Log Files geplant haben. Dabei sollte amn immer 1 oder 2 Jahre in die zukunft planen.
Dazu gehören beispielsweise die Konfiguration des Speicherplatzes. Auf diese Thematik bin ich im theoriepost zum Oracle DBMS schon etwas eingegangen. Zu planen gibt es hier sachen wie die Verteilung der Redo Logs Dateien, Control Dateien und Tablespaces-Datendateien auf die verschiedenen Speichermedien, die Technologie der Speichermedien wie beispielsweise SAN, RAID, LVM usw. Desweiteren gilt es das Einsatzszenario der Datenbank zu planen, etwa OLTP oder OLAP usw.
hier eine kleine Beispielsplanung
Datenbankname und SID
| SID | myicadb |
| DB_NAME | myicadb |
Tablespaces
| Tablespace Name | Datafile | Size |
| system | /u01/oracle/oradata/myica/sys.dbf | 500 M |
| users | /u01/oracle/oradata/myica/usr.dbf | 100M |
| undotbs | /u01/oracle/oaradata/myica/undo.dbf | 100M |
| temp | /u01/oracel/oradata/myica/temp.dbf | 100M |
| index_data | /u01/oracle/oradata/myica/indx.dbf | 100M |
| sysaux | /u01/oracle/oradata/myica/sysaux.dbf | 100M |
Logfiles
| Logfile Group | Member | Size |
| Group 1 | /u01/oracle/oradata/myica/log1.ora | 50M |
| Group 2 | /u01/oracle/oradata/myica/log2.ora | 50M |
| CONTROL FILE | /u01/oracle/oradata/myica/control.ora |
| PARAMETER FILE | /u01/oracle/dbs/initmyicadb.ora |
Das Parameter file kommt unter Unix in das Berezcihnis ORACLE_HOME/dbs und unter Wnidows in ORACLE_HOME/database.
Desweiterne muss etnscheiden werden, welche größe der Parameter DB_BLOCK_SIZE bekommen soll. gängig sind 4K oder 8K
Jetzt erstellenw ri die datenbank. Dazu loggen wir uns in den oracle account und machen die Verzeichnisse für die Datenbank
mkdir /u01/oracle/oradata/myica

mkdir /u01/oracle/oradata/myica/bdump

mkdir /u01/oracle/oradata/myica/udump

mkdir /u01/oracle/oradata/myica/recovery
Nun erstellenw ir da parameter file indem wir das Standardtemplate init.ora kopieren und dann die benötigten APrameter setzen.
cd /u01/oracle/dbs

cp init.ora initmyicadb.ora

vi initmyicadb.ora

DB_NAME=myicadb

DB_BLOCK_SIZE=8192

CONTROL_FILES=/u01/oracle/oradata/myica/control.ora

UNDO_TABLESPACE=undotbs

UNDO_MANAGEMENT=AUTO

SGA_TARGET=500M

PGA_AGGREGATE_TARGET=100M

LOG_BUFFER=5242880

DB_RECOVERY_FILE_DEST=/u01/oracle/oradata/myica/recovery

DB_RECOVERY_FILE_DEST_SIZE=2G

# die folgende APrameter werden nur in Oracle-Versionen 10g und früher benötigt

BACKGROUND_DUMP_DEST=/u01/oracle/oradata/myica/bdump

USER_DUMP_DEST=/u01/oracle/oradata/myica/udump
Jetzt setzen wir die ORACLE_SID umgebungsvariable und starten die Instanz
export ORACLE_SID=myicadb

sqlplus

enter User: / as sysdba

SQL>startup nomount
jetzt erstellen wir die datenbank
create database myicadb


datafile '/u01/oracle/oradata/myica/sys.dbf' size 500 M

sysaux datafile '/u01/oracle/oradata/myica/sysaux.dbf' size 100M

undo tablespace undotbs

datafile '/u01/oracle/oaradata/myica/undo.tbf' size 100M

logfile

group 1 '/u01/oracle/oradata/myica/log1.ora' size 50M,

group 2 '/u01/oracle/oaradata/myica/log2.ora' size 50M;
Bei Fehlern kann man die Datei alert_myicadb.log im Verzeichnis BACKGROUND_DUMP_DEST zu Rate ziehen. Vor erneutem Probieren sollte man alle Dateien in /u01/oracle/oradata/myica löschen.
Jetzt wurde die datenbank erstellt, gemountet und geöffnet. Wir erstellen nun zusätzliche Tablespaces
SQL>create tablespace users datafile '/u01/oracle/oradata/myica/usr.dbf' size 100M;

SQL>create tablespace index_data datafile '/u01/oracle/oradata/myica/indx.dbf' size 100M;
jetzt installieren wri die Data dictionaries
SQL>@/u01/oracle/rdbmbs/admin/catproc.sql
jetzt installieren wir die procedural option
SQL>@/u01/oracle/rdmbs/admin/catproc.sql
Jetzt ändern wir die Passwörter für die Accounts sysi und system.
SQL>alter user sys identified by myica;

SQL>alter user system identified by myica;
Jetzt erstellen wir wieter euser accounts.
SQL>create user scott default tablespace users identified by tiger quota 10M on users;

SQL>grant connect to scott;
Jetzt fügen wir die Datenbank noch in die Datei listener.ora hinzu und starten den Listener neu
cd /u01/oracle/network/admin

vi listener.ora
LISTENER =
(DESCRIPTION_LIST =
(DESCRIPTION =
(ADDRESS =(PROTOCOL = TCP)(HOST=200.200.100.1)(PORT = 1521))
)
)
SID_LIST_LISTENER =
(SID_LIST =
(SID_DESC =
(SID_NAME = PLSExtProc)
(ORACLE_HOME =/u01/oracle)
(PROGRAM = extproc)
)
(sid_desc =
(sid_name=orcl)
(oracle_home=/u01/oracle)
)
#Add these lines
(sid_desc =
(sid_name=myicadb)
(oracle_home=/u01/oracle)
)
)
lsnrctl stop

lsnrctl start
über den DBCA
Unter Windows erreichen sie den DBCA über Start / Oracle – Ora<Version>_home / Configuration and migration tools / datbasae Confiugration Assistant. altenraitv können Sie einfach in einer eingabeaufforderung dbca eintippen.
Unter Linux befinet sich das Tool im bin-Ordner des oralce-Home-Directories, unter welchem Sie die oracle-Instanz installiet haben, also beispeislweise /u01/oracle/<version>/bin.
- Im ersten Bildschirm des DBCA klciekn wir auf next
- danach wählen wir Create a Database
- jetzt müssen wir ein tempalte auswählen. Für eien Grundinstallation sollte heir meist general purpose or Transaction processing gewählt werden, ebenfalsl ist dies das beste Template für OLTP-Datenbanken. Das Data Warehouse-Template ist das beste für OLAP-Datenbanken.
Erst, wenn Sie ein erfahrener DBA sind, werden sie irgendwann eine komplette custom-Installation durchführen, bei welcher sie also kein vorgefertigtes Template nehmen.
- jetzt sollen wir den Datenbanknamen und die SID angeben. Als Globale Database Name gibt man normalerweise den Namen der Datenbank + die Domain an, also beispielsweise orcl.<deineName>.com
- als nächstes werden wir gefrag,t ob wir das Web Access control utility, auch enterprise amnager, nutzen wollen. Diese option aktiviert zu lassen ist empfohlen.
- wir werden darauf higneweisen, dass wir einen Lsitener konfigurieren müssen.
Unter windows erreichen wir die Kofniguration unter Start / Oracle – Ora<version>_home /configuration nad migration tools / net configuration Assistant
- wir licken auf Lstiener Configuration
- Add
- Defualt Lsitener
- als Network protocols wählen wir TCP und IPC
- Port Number lassen wir auf 1521. in einer produktivumgebung sollten Sei hingegen eventuell einen alternativen Port konfigurieren.
- da wir IPC kofniguriert haben, müssen wir einen Schlüssel angeben. Zum Testen können Sie heir etwas simples wie beispielsweise ipc nutzen.
- No – wir wollen keinen weiteren Listener konfigurieren.
- zurück im DBCA gehen wir auf den Reiter atuoamtic maintenance Tasks und lassen den Haken bei Enable automatic maintenance tasks drin
- wir sollen nun administrative Passwörter vergeben.
- wir werden nun gefragt wo die datnebankfiles gespeichert werden sollen udn welchent yp von speicher wir nutzen wollen. Wir können entweder das normale Dateisystem nuten oder das Autoamtic Stroage Management. Für die Grundinstallation wählen wir Dateisystem.
- flash recovery area lassen wir an. Das ist die Standardarea für unsere Backups. Ebenfalls archivieren wir die Archivierung.
- Sample Schema lassen wir in der Regel aus. Die option ist sinnvoll,w enn Sie ein Entwickler sind, da sie dort einen TAblespace EXAMPLE mit Beispieldatensätzen bekommen.
- jetzt habenw ri ein Fenster mit vier Registerkarten. In der Registerkarte Memory legen Sie die maximalgröße von SGA und PGA fest, die Sie beide im theoriepost kenenngelernt haben.
in der dritten Registerkarte sollten Sei unicdoe wählen, wenn ihre Datenbank internationale Zeichensätze untrstützen soll.
in der regsiterkarte Connection mode bekommen Sie die Auswhal zwischen Dedicated server mode (verbruacht mehr RAM, ist aber etwas sicherer)
- das nächste fenster behandelt die speicheorrte unserer redo log groups,l datafiles und control files. Vorerst sollten Sei das einfach nur durchklicken und später genauer konfigurieren. Denn wie im Theorie-Teil bereits behandelt, sollten Sei die Redo Logs über mehrere Datenträger verteilen
- nun aktivieren wir im letzten Fenster noch die Haken bei Create Database und Save as a Databsae template oder als Alternative Generate Databse creation Script.
- Nun klicken wir weiter und der DBCA erstellt unsere Datenbank.
- Enterprise Edition. Sozusagen dei Vollversion. bietet sämtlcihe Features der oracle DB
- Standard Edition. ist bsechränkt auf maximal 4 CPU Sockets auf dem Mainboard, bietet außerdem Real Application Clustering
- Std Edition One. Beschrnktt auf maximal 2 CPU sockets auf dem Mainboard und kostet 180 USD/User
- Express: kostenlose Version zum Entwickeln, Testen und Lernen. Außerdem ist die Express Version eine gute Wahl, wenn man freie Software, die auf einer Oracle-Datenbank aufsetzt, verbreiten möchte.
Installation von Oracle
Bevor wir zu den einzelnen installationsroutinen kommen, hier ein paar grundlegende Empfehlungen:
- zum Betrieb einer Oracle Database braucht man mindestens 1 GB an freier RAM-Kapazität
- der virtuelle RAM oder auch Swap sollte die doppelte Größe des RAMs einnehmen
- ihr braucht mindestens 6 GB freien Speicherplatz auf der festplatte
Zusätzlich zu diesen hier geschilderten grundstzlcihen Schritten sollten sie bei jeder installation den zugehörigen installation Guide für das verwendete Betriebssystem lesen. Diesen finden Sie über eine Google Suche nach Oracle online Documentation Library und dort dann unter installing and Upgrading.
unter Windows
In der Regel wird Oracle als DVD ausgeliefert. In dieser DVD befindet sich die Setuproutine unter database\setup.exe. Daraufhin öffnet sich kurz eine Eingabeaufforderung, die darüber informiert, dass der Oracle Unviersal Installer gestartet wird. dieser wird dafür in ein Temp-Verezichnis kopiert.
- Im ersten Fenster wird nach einer e-Mail-Adresse gefragt, die man ignorieren kann.
- Im nächsten Fenster empfiehlt sich grundsätzlich die Option Create or configure database. Aus Übungszwecken werden wri die zweite Option Install database software only auswählen.
- in diesem Tutorial werden wir noch kein Oracle-Cluster aufsetzen, sondern lediglich eine einzige Systeminstanz. Deswegen wählen wir die erste Option Single Instance databse installation.
- Als nächstse sollen wir eine Sprache auswählen – diese Auswahl ist ziemlich einfach zu treffen.
- danach soll die zu installierende Edition ausgewählt werden.
- Als nächstes sollt ihr die Base-Directory und das Software-Installatiosnverzeichnis angeben. Dabei ist es empfehlenswert, nicht das C:\-Laufwerk zu verwenden.
- Im nächsten Fesnter erhalten Sie eine Zusamemnfasung. Mit einem Klick auf Finish starten Sie die installation.
damti wäre die Installation an sich erstmal abgeschlossen. Als nächstes müssen wir den Oracle Listener konfigurieren. Konfigurieren wir diesen nicht, kann eine Cleintanfrage zu einer datenbankverbndung nicht beantwortet werden. Diesen finden wir im Startemenü unter Oracle – OraDB<Releasenummer>_Home1 – Confiugration and Migration – Net Configuration Assistant.
- Im erste Fesnter wählen wir Listener Configuration
- da noch kein Listener konfiguriert wurde, wählen wir im näcshten fenster Add, um einen neuen Listener anzulegen.
- Den Standardnamen LISTENER im nächsten fenster können wir so lassen
- Im nächsten Fenster wählenw ir als protkoll TCP
- und im nächsten Fenster nutzen wir den Standard-TCP-port 1521
- Da wir derzeit nur einen einzigen Listener konfiugrieren wollen, wählenw ir m nächsten Fenster No.
- die Listener konfiguration ist vollständig.
Dann erstellen und konfigurieren wir eine Datenbank. Dazu öffnen wir den Databse configuration Assistant
- im ersten Fenster wählen wir Create a Database
- im nächsten fenster wählenw ir die Standardoption Operational Purpose of transaction Processing
- wir vergeben einen global Databse name. Da wir nur eine einzige system-Instanz erstellt haben und keinen Cluster, ist der Global Database Name identisc mit der SID. Standardäßig wird hier oft ORCL eingegeben.
- Im nächsten fenster lassen wir erstmal alles auf Standard
- Im nächsten Fenster lassen wird ie Option Use Diuffrente Administrative Passwords aktiviert – es sei denn, Sie wollen für alle Accounts das selbe haben.
- Im nächstne Fenster stellenw ri sicher, dass im feld Storage Type die Option File System aktiviert ist. Wir nutzen auch die standardoption use database file locations.
- Im nächsten Fenster müssenw ir eine recovery area angeben. für usnere Zwecke reicht hier erstmal die Stndardoption.
- Im nächsten Fehlern wäre es aus Lernzwecken zu empfeheln, Sample Schemas zu aktivieren. In Produktivumgebungen übersprügnt man diese option.
- Im nächsten Fenster lassen wir in diesem Fall alles so, wie es ist.
- Wir kommen zur Konfiguration des Databse Storage.
- wir aktivieren die Checkbox Create Database. mit Finish starten wir die Erstellung.
Als nächstes müssen wir einen SErvice Name konfigurieren. Wenn ein Cleint versucht, sich mit der datenbank zu identifizieren, wirddiese durch einen Servicenamen identifiziert. Das geht ebenfalls über den Net configuration Assistant.
- im Hauptmenü wählen wir diesmal configure local service name
- da wir noch keinen Servicename konfiguriert haben, wählen wri im nächsten fenster Add
- als Service name geben wir den Computer / Host Namen des Rechners, auf dem wir den Datenbankserver installieren, an. Wenn die IP-adresse immer fix ist, kann man hier auch die IP eingeben.
- als Protokoll wählenw ri wieder TCP
- wir geben den Hostnamen des Rechners ein und nutzen wieder den STandard-TCP-Port 1521
- wir wählen Yes, perform a test
- wenn jetzt ein fehler kommt liegt es darin, dass Oracle versucht hat, sich mit seinem Standardpasswort einzuloggen. Mit dem Button Change Login geben wir das Passwort ein, welches wir zuvor festgelegt haben, und gehen auf Next.
- Der test wird nun erfolgreich sein und wir müssen wir den Net Service Name eingeben.
- wir wollen keinen weiteren net service name konfigurieren, also no
- Konfiguration fertig
Jetzt öffnenw ir die Datenbank um zu überprüfen, ob aleles läuft. dazu im startmenü auf Oracle – OraDB<releasenummer>_Home1 – Databse control – <Service name>. Es öffnet sich ein Browserfenster, indem wir unsere Logindaten eingeben sollen.
unter Linux
als erstes erstellen wir benötigte user und gruppen
groupadd -g 501 oinstall

groupadd -g 502 dba

groupadd -g 503 oper

useradd -u 502 -g oinstall -0 dba,oper oracle -o -p oracle
dann öffnenw ridie sysctl.confg mit dem vi und fügen das folgende hinzu:
kernel.shmall = 2097152

kernell.shmmax = 2147483648

kernel.shmni = 4096

kernel.sen = 250 3200 100 128

net.core.rnen_default = 4194304

net.core.rnen_max = 4194304

net.core.wnen_default = 262144

net.ipv4.ip.loca.port_range = 9000 65500

fs.file-max = 6815744

net.core.wnen_max = 1048576

fs.aio-max-nr = 1048576
dann gehen wir mit dem vi in die datei /etc/security/limits.conf, scrollen dort nach ganz unten und fügen über # End of file folgendes ein
oracle soft nproc 2047

oracle hard nproc 16384

oracle soft nofile 1024

oracle hard nofile 65536
Jetzt erstellenw ri die groba struktur, in dei wir unser oracle installieren wollen, und setzen entsrpecehnde rechte
mkdir /opt/oracle

mkdir /u01

chown -R oracle:oinstall /u01

chmod -R 775 /u01

chown -R oracle:oinstall /opt/oracle

chmod -R 775 /opt/oracle

cd /bkup

chwon -R oracle:oinstall database

chmod -R 775 database
für den User oracle müssen wir jetzt ncoh einige Umgebungsvariablen setzen, damit das ganze hin haut
su oracle

vi /home/oracle/.bash_profile

PATH=$PATH:$HOME/bin

export PATH

export TMP=/tmp

export TMPDIR=$TMP

export ORACLE_HOSTNAME=<your_hostname>

export ORACLE_UNQNAME=<your_hostname>

export ORACLE_BASE=/opt/oracle

export ORACLE_HOME=$ORACLE_BASE/product/11.2.0/db_1

export ORACLE_SID=<your_hostname>

export PATH=/usr/sbin:$ORACLE_HOME/bin:$PATH

export LD_LIBRARY_PATH=$ORACLE_HOME/lib/lib:/usr/lib:/usr/lib64

export CLASSPATH=$ORACLE_HOME/JRE:$ORACLE_HOME/jlib:$ORACLE_HOME/rdbms/jlib:$ORACLE_HOME/network/jlib

export PATH=$PATH:$ORACLE_HOME/bin:$ORACLE_HOME/opatch
Jetzt müssen wir Abhängigkeiten installieren
binutils

compat-libstdc++

compat-libstdc++ (32 bit)

elfutils-libelf

elfutils-libelf-devel

gcc

gcc-c++

glibc

glibc (32 Bit)

glibc-common

glibc-devel

glibc-devel (32 Bit)

glibc-headers

ksh

libaio

libaio (32 Bit9

libaio-devel

libaio-devel (32 Bit)

libgcc

libgcc (32 Bit)

libgonp

libstdc++

make

numactl-devel

sysstat
Nun können wir die installation im Home-Ordner von oracle starten. Dort kopieren wir die inhalte der DVD oder des download-paketes in den Ordner databse und führen die datei ./runInstaller.sh aus.
Die installation können wir durchklicken. Nach der grafischen ionstallation führen sie das skript /u01/app/oraInventory/oraInstRoot.sh sowie /u01/app/oracle/product/11.1.0/db_1/root.sh aus, falls diese nicht schon autoamtisch vom installationsterminal ausgeführt werden sollten.
Installation über ein Response File
Wenn Sie irgendwann einmal aus welchem Grund auch immer die Oracle installation nicht über die GUI, sondern vorgeskriptet über die Kommandozeile ausführen wollen, dann können Sie sich eine Antwortdatei basteln, welche die Antworten afu die Fragen gibt, die der Oracle Universal installer in der GUI normalerweise stellen würde, und die installation auf Kommandoebene starten.
./runInstaller.sh -silent -responsefile <Dateiname>
Die einfachste Möglichkeit, eine Antwortdatei zu erstellen, ist bei der Erstinstallation über den OUI die Optionen abspeichern zu lassen und sich die Datei aufzuheben.
Erste Nacharbeiten nach der installation
Als erste Aktion nach der installation der Software erstellen Sie eine neue Oracle Datenbank. Wie das geht, zeige ich Ihnen in diesem Post
Wenn dir dieser Post gefallen hat, teile ihn doch auf Social Media, abonniere und verfolge mich per E-Mail, RSS-Feed, Social Media oder registriere dich auf meiner Seite. Wenn du registriert bist, like den Post bitte, wenn er dir gefallen hat!]]>Instanz und Datenbank
eine Oracle-Datenbank besteht im wesentlich aus der Datenbank an sich und der Oracle-Serverinstanz.
Die Oracle-Serverinstanz ist das Hauptprogramm, welches sozusagen die Anwendungsschicht des Oracle-Datenbankmanagementsystems darstellt. Das bedeutet, dass andere Programme und nutzer, die Daten von der eigentlichen Datenbank abrufen oder bearbeiten wollen, sich erst an diese Oracle-Instanz wenden müssen. Diese ist also der Serverdienst, der im Hintergrund läuft. Die Oracle-Instanz liegt im laufenden Betrieb, wie viele andere Serverdienste auch, im Arbeitsspeicher des Systems und wartet dort auf eingehende Verbindungen, die von den Nutzern angefragt werden.
Die Einstellungen der Oracle-Serverinstanz wird wie bei vielen anderen Serverdiensten auch in einer oder mehreren Konfigurationsdateien gespeichert – im Fachjargon auch Parameterdatei genannt. Die aprameterdateien werden vor dem Start einer Oracle-Instanz gelesen und dann auf die jeweilige Instanz angewendet.
Die eigentliche Datenbank symbolisiert die Datenhaltungsschicht des Systems. Die Datenbank liegt zum größten Teil auf der festplatte oder SSD des Systems. Dort werden die ganzen Daten, die letztendlich durch die Oracle-Serverinstanz abgefragt und bearbeitet werden sollen, hinterlegt.
Es gibt immer mindestens eine Oracle-Instanz für eine Oracle-Datenbank. man kann nicht mehrere Oracle-Datenbanken mit einer einzigen Oracle-Instanz verwalten. Damit unterscheidet sich Oracle sehr stark von anderen Datenbankmanagementsystemen wie beispeislweise MySQL, wo man mit einer einzigen Serverinstanz mehrere datenbanken verwalten kann.
Umgekehrt ist es aber möglich, dass sich mehrere Oracle-Instanzen um eine einzige Oracle-Datenbank kümmern, das nennt man dann ein Redundancy Array oder allgemein bekannt als Cluster. Dadurch wird die Performance-Last auf mehrere Instanzen aufgeteilt. Desweiteren ist es möglich, dass man eine instanz verwaltet, backupt oder wartet, während die andere weiterhin auf Clientanfragen reagiert und die Datenbank für Clients zur Verfügung stellt.
eine Transaktion
eine Transaktion fasst Datenänderungen, die voneinander abhängig sind, zusammen. Damit Sie das verstehen können, müssen Sie mit dem Begriff der relationalen Datenbanken vertraut sein. Wenn ein Benutzer einen Datensatz ändert, dann müssen in einer relationalen Datenbank Datensätze in verschiedenen Tabellen geändert werden, also nicht nur in einer einzigen – weil dei Tabellen zueinander in einer Beziehung stehen. Wenn ein alter mitarbeiter aus einem Unternehmen ausscheidet und ein neuer seine Aufgaben übernimmt, müssen bie allen Aufgaben, die dieser alte Mitarbeiter bearbeiteet hat, unter Umständen die Daten des neuen mitarbeiters als Verantwortlicher eingetragen werden. Deswegen müssen in mehreren verschiedenen Tabellen Änderungen erfolgen, so dass dies umgesetzt werden kann.
Es wäre fatal, wenn in einigen Tabellen die Änderungen schon erfolgt wären, und mittendrin schmiert die Oracle-Instanz ab. Nun haben Sie in einigen Tabellen den neuen Mitarbeiter und in einigen den alten Mitarbeiter drin stehen. Die von der Datenbank abhngigen Programme können die Daten nicht mehr richtig zuordnen und spucken mitunter Fehlermeldungen aus. Damit dies vermieden wird, gibt es Transkationen. Eine Transaktion fasst alle Änderungen in verschiedenen Tabellen zusammen, die zu einer bestimmten Änderung von Daten gehören. Erst, wenn alle Änderungen vollständig und erfolgreich durhcgeführt wurden, werden die Änderungen permanent übernommen. Geht zwischendrin etwas schief, bleiben alle Daten auf dem Stand vor der Transaktion, bis irgendwann bei einem erneuten Versuch alle Änderungen erfolgreich durchgeführt werden können. Somit werden Inkonsistenzen vermieden.
Und nicht nur das System kann solche Transaktionen automatisch auf diese Art und Weise zurücksetzen. Auch manuell können solche Transaktionen innerhalb einer Sitzung zurückgerollt werden. Wenn ihr Chef Ihnen sagt, dass Sei in der Datenbank einen Termin für 09:00 uhr in seinem Terminaklender um eine Stunde verschieben sollen, Sie 10:00 Uhr eintragen und der Chef Ihnen hinterherruft „Ach lassen Sie’s, es klappt doch mit 09:00 Uhr“, dann können sie manuell veranlassen, dass die Änderung rückgängig gemacht wird. Der Nutzer wird hierzu natürlich nicht die notwendigen Datenbank-Befehle eingeben, das macht für Ihn meist das Anwendungsprogramm, welches im Hintergrund mit der Oracle-Instanz zusammenarbeitet.
Die System Global Area
Die System Global Area (SGA) ist eine Art Datenspeicher im Arbeitsspeicher des Systems, der wichtige Dateien in diesem zwischenspeichert. Die Daten, die über das SGA im Arbeitsspeicher abgelegt werden, sind beispeislweise Metadatan doer Systeminfomrationen zur Datenbank, die somit nicht jedesmal von der Festplatte über die Datendateien gelesen werden müssen, was Zeit spart. Aber auch Daten aus der Datenbank, die immer wieder abgefragt werden, werden hier abgelegt und „gecached“, damit nicht dauernd zeitintensive Lesezugriffe auf die Festplatte stattfinden müssen. Die oracle-Datenbank speicher häufig abgefragte Datensätze auch „Datenbankblöcke“ oder „Zeilen“ einer Datenbank deswegen im Database Buffer Cache auf dem Arbeitsspeicher. Dabei erkennt die Oracle-Datenbank, auf welche Datenbankblöcke besondesr häufig zugegriffen wird und hält diese wesentlich länger im Arbeitsspeicher vor als andere, die nur für eine gewisse Zeitspanne gebraucht werden.
Aber auch die Redo Logs, die wir später noch kenennlernen werden, haben in der SGA ihr zu Hause.
Einige der Daten, die über das SGA im Arbeitsspeicher zwischengespeichert werden, werden auf die Festplatte geschrieben, sobald die Oracle-datenbank mal weniger stark belastet wird und daher Ressourcen frei sind, um nebenbei die Daten auf die Festplatte zu sichern. Das geschieht beispielsweise bei den Redo Logs, die wir später noch kennen lernen werden. Ebenfalls später kennen lernen werden wir noch den Shared Pool und die Dirty List, die sich ebenfalls in der SGA befinden.
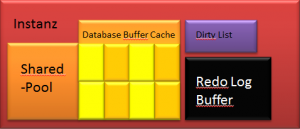
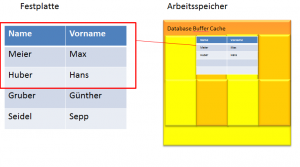
Die System Global Area befindet sich wie bereits erwähnt im Arbeitsspeicher und gehört deshalb architektonisch zur oracle-Instanz, da sich diese ja im Arbeitsspeicher befindet.
OLAP und OLTP Datenbanken
Je nach Anwendungsszenario einer Datenbank unterschiedet man zwischen einer OLAP und einer OLTP-Datenbank. Dabei geht es um den Einsatzzweck der Datenbank. Je nach Einsatzzweck wird eine datenbank unterschiedlich ausgerichtet. Einen praxisorientierten, eifnach verständlichen Vergleich zwischen OLAP und OLTP-anwendungen und deren Datenbanken habe ich in meinem Post zu SAP Business Warehouse gegeben.
OLTP-Datenbanken haben eine hohe Transaktionsrate aus, deren Änderungen innerhalb einer Transkation aber klein sind. Das heißt: pro Transaktion müssen nur wenige Daten abgerufen und bearbeitet werden, es gibt jedoch viele dieser kleinen Datenänderungen. Das ist beispielsweise bei einer ERP-Software, in der ständig neue Kundenaufträge und Bestellungen bei Lieferanten eingearbeitet werden, der Fall.
OLAP-Datenbanken werden regelmäßig mit Daten befüllt. Diese Datenbestände werden allesamt abgerufen und analysiert. Es werden also in einem Schritt große Mengen an Daten abgerufen. Hier ist die regelmäßigkeit und Anzahl der Transaktionen also gering, deren Datenumfang aber sehr groß. Business intelligence Systeme sind beispielsweise Softwarelösungen, die von OLAP-Datenbanken Gebrauch machen.
Was bedeutet jetzt diese Einteilung genau? Nun, nehmen wir mal aus der oberen Erklärung das Beispiel des Database Buffers.
Im Database Buffer cache liegen also Tabellenblöcke, also Zeilen, die sehr häufig abgefragt werden. Diese werden im Arbeitsspeicher vorgehalten, da sie von dort aus wesentlich schneller abgefragt werden können als von der Festplatte.
Je größer diese Tabellenblöcke, desto mehr Zeilen einer tabelle können vorgehalten werden. Mit einem größeren TAbellenblockals dem oben dargestellten könnten wir also statt zwei Zeilen alle vier Zeilen der Beispieltabelle im Arbeitsspeicher vorhalten. Bleibt die Größe der Tabellenblöcke so wie sie ist, müssen wir die beiden Zeilen für die Mtiarbeiter Gruber und Seidel in einen extra Tabellenblock laden, was dann so aussähe.
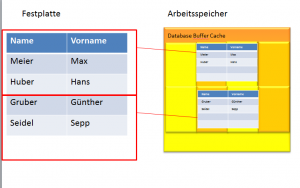
Jetzt nehmen wir mal an, diese mitarbeiterdaten werden in einem ERP-System ab und zu mal wieder abgerufen, weil beispielsweise jemand im Urlaubskalender nachsehen will, ob der Kollege Meier im nächsten Monat Urlaub hat, dann wird vielleicht das Urlaubskonto des Kollegen Gruber aktualisiert, der Kollege Seidel trägt Überstunden vom letzten Samstag ein usw. Hier macht es mehr Sinn, wenn wir die vier Zeilen in zwei Tabellenblöcke aufteilen. Denn wenn wir die vier Zeilen auf zwei Tabellenblöcke aufteilen, dann müssen bei jeder Abfrage nicht alle vier, sondern nur jeweils zwei Zeilen vom Arbeitsspeicher geladen werden, was unter Umständen stark vereinfach ausgedrückt jedes mal halb so lang dauert, als wenn wir alle vier Zeilen aus dem Arbeitsspeicher abrufen müssten. Logisch, oder?
Jetzt nehmen wir aber mal an, diese Mitarbeiterdatensätze sind mit einer anderen Tabelle in Verbindung, welche die Umsätze dieser mitarbeiter im letzten Quartal abgespeichert hat, verbunden. Diese leigt ebenfalls im Database Buffer cache. Ebenso liegt eien Tabelle im Cache, welche die mitarbeiter verschiedenen Filialen zuordnet.
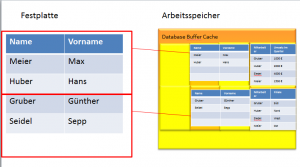
In unserem Business intelligence System sind jetzt diese Daten drin und wir wollen analysieren, welche Filiale im letzten Quartal den größten Umsatz gemacht hat. Die Analyse läuft folgendermaßen: Aus dem Database Buffer cache wird die Tabelle mti den mitarbeiterumsätzen genommen. Dei erste Zeile wird gelesen. Damit die vollständigen Daten zum mitarbeiter Gruber in der resten Zeile angezeigt werden kann, muss erst der obere Tabellenblock gelesen werden und danach der Tabellenblock rechts unten mit den Filialen. In der zweitene Tabelle muss der untere Tabellenblock geladen werden, in der dritten Zeiel wieder der obere Tabellenblock. Wenn nun hingegen die beiden Tabellenblöcke für die Mitarbeiter zusammengelegt werden,a lso alle vier Zeilen in einem Tabellenblock, müssten nur ein einziges mal die drei nun jeweils vierzeiligen Tabellenblöcke geladen werden und die analyse könnte komplett durchgeführt werden. Der Unterschied ist hier noch nicht wirklich groß – wenn Sie mitgezählt haben stellen Sie fest, dass Sie mit der ersten Varainten insgesamt acht Mitarbeiterzeilen vom Arbeitsspeicher laden und in der zweiten Variante einmalig die vier mitarbeiterzeilen laden müssen. Außerdem hätten Sie auch in der ersten Variante nur vier mitarbeiterzeilen laden müssen, wenn die Mitarbeiter in der umsatztabelle in der optimalen Reihenfolge gestanden hätten, also nach Gruber kommt Seidel und danach kommen Meier und Huber. Aber sie merken: je komplexer die Datenanalysen werden, desto eher lohnen sich größere Datenbankblöcke im SGA des Systems.
Und genau dies ist der Unterschied, der den Einsatzzweck von OLTP-Datenbanken und OLAP-Datenbanken ausmacht. Die Größe der tabellenblöcke macht im wesentlichen den Einsatzzweck der Datenbanken aus, für den sie am besten geeignet sind.
Die Dirty List
Wir haben weiter oben das Konzept des Database Buffer Caches kennengelernt, in welchem wie nun bereits bekannt verschiedene Datensätze der Datenbank im Arbeitsspeicher vorrätig gehalten werden. Je anchdem, ob wir ein OLTP oder OLAP-System haben, wählen wir die Größe dieser Tabellenblöcke unterschiedlich. So weit so gut.
Nicht nur die Lesevorgänge, sondern auch die Schreibvorgänge in Datensätze werden zunächst im Arbeitsspeicher hinterlegt. Dazu werden die im Arbeitsspeicher hinterlegten Tabellenblöcke abgeändert. Das heißt für einen bestimmten Zeitraum befinden sich im Database Buffer cache und somit im Arbeitsspeciher die aktualisierten Datensätze, während auf der festplatte noch die veralteten Datensätze drin stehen.
Irgendwann müssen diese geänderten Datensätze auf die Festplatte geschrieben werden, denn wenn irgendwann der Server heruntergefahren wird oder der Strom weg ist, gehen die Änderungen im Arbeitsspeicher verloren.
Die Dirty List enthält die Adressen der Tabellenblöcke im Database Buffer Cache, die geänderte datensätze enthalten. Wenn die Oracle-Instanz sich dazu entscheidet, geänderte Datensätze vom Arbeitsspeicher auf die Festplatte zu schreiben (etwa weil gerade wenig Last auf dem System ist), dann nimmt die Oracle-Instanz die Dirty List und guckt nach den Tabellenblöcken, die geändert wurden. Diese tbaellenblöcke werden dann auf die Festplatte geschrieben. Auch hier spielt die Größte der tabellenblöcke, die wir in der Differenzierung zwischen OLTP und OLAP besprochen haben, wieder eine Rolle – denn je größer die Tabellenblöcke, desto mehr muss geschrieben werden, obwohl sich mitunter weniger Zeilen geändert haben, als im Tabellenblock vorhanden sind.
Redo Logs
Wir haben ja jetzt weiter oben gelernt, dass Änderungen in der datenbank erst im Arbeitsspeicher, genauer gesagt im Database Buffer Cache, durchgeführt werden, beovr sie auf die festplatte geschrieben werden. In er Zeit, in der diese Änderungen noch nicht auf der festplatte geschrieben sind, könnte ja theoretisch ein Stromausfall oder ähnliches passieren, oder enifach nur die Oracle-Instanz gestoppt werden, so dass die Änderungen im Arbeitsspeicher verloren gehen. Um dies weitestgehend zu verhindern, werden Änderungen zusätzlich in redo Logs protokolliert. Für jede datensatzänderung werden die blockadresse des geänderten Tabellenblocks, dessen neuer wert, der Zeitstempel des Änderungszeitpunkts und eine Systemänderungsnummer gespeichert.
Die Redo Logs selbst liegen jedoch wiederum im Arbeitsspeicher, nämlich im Redo Log Buffer. was ist also der Vorteil? Der sogenannte Redo-log-writer schreibt permanentden inhalt des Redo-Log-Buffers in sogenannte Redo-log-Dateien auf die festplatte. Sie fragen sich vielleicht, warum man denn dann nicht gleich die Änderungen vom Daatbase Buffer cache auf die Datendateien der festplatte schreibt? Dazu gibt es mehrere Gründe
- es geht wesentlich schneller. Um eine Redo-Log-Datei zu schreiben, welche die aktuelle Änderung im Database buffer Cache an einem Tabellenblock enthält, muss nur die Redolog-Datei im Dateisystem gesucht, geöffnet und beschrieben werden. Um die Änderung in die datenbankdateien zu schreiben, muss diese gesucht, geöffnet, gelesen, in dieser nach der zugehörigen Tabelle gesucht werden, die Tabelle eingelesen werden, in der tabelle der zugehörige Datensatz gelesen werden und der Datensatz neu geschrieben werden. Das heißt: mit Redo-Logs hat man die änderungen an einem Datensatz wesentlich schneller auf der festplatte als über die Datendateien und verkleinert somit wesentlich das Zeitfenster, in dem etwas schief gehen kann, weil das System eventuell abstürzen könnte. Desweiteren ist die Redo-Log-Datei eine einzige zusammenhänge Datei, wohingegen die Datenbankdateien mitunter mehrere Dateien sind, die sich an unterschiedlciehn Stellena fu der festplatte befinden können, so dass der Schreib-/Lesekopf der festplatte hier öfter hin und her springen muss.
- Es muss nur geschrieben und weniger gelesen werden. Wie oben bereits erklärt, muss beim Speichern von Änderungen in die Datenbankdateien diese erst gelesen und analysiert werden, um die Änderungen in dei richtige Tabelle zu schreiben. bei der Redo-Log Datei muss fast gar nichts gelesen, sondern nur geschrieben werden. Das erhöht die Performance dieser Schreibvorgänge, weil die Köpfe der Festplatten nicht erst den beschriebenen Bereich einer platte lesen und dann zu eienm unbeschriebenen Bereich springen und diesen beschreiben müssen
- Da wie bereits erwähnt die Performance dieses Schreibvorgangs der Redo-logs besser ist als beim Schreiben in die Datenbankdateien, können die Redo-Logs ohne probleme auch geschrieben werden, wenn das System derzeit belastet wird
- Wie bereits beschrieben, werden bei einer Änderung an einem Tabellenblcok im DAtabase Buffer Cache nicht nur die Änderungen, sondern der geasmte Tabellenblock aus dem arbeitsspeicher neu auf die Festplatte geschrieben.In den Redo-logs hingegen werden nur die Änderungen an den Tabellenblöcken geschrieben, nämlich der SQL-Code der zu dieser Änderung geführt hat. Das führt dazu, dass man merhere Änderungen an ein und demselben Tabellenblock über einen längeren Zeitraum sammeln kann und sie erst später über den Database Buffer Cache vom Arbeitsspeciher auf die Festpaltte speichern muss und die Änderungen an den Tabellenköpfen trotzdem über die Redo-Logs ständig auf der Festplatte mitschreiben kann. Das führt dazu, dass nicht so oft der überflüssige, gleichbleibende Anteil an Daten in den Tabellenblöcken immer wieder neu auf die festplatte geschrieben und von dort weider neu in de Arbeitsspeicher geladen werden muss.
- Man kann die Schreib- und Leseperformance mehrerer Datenträger sinnvoll kombinieren. So kann ein Datenträger die RedoLogs schreiben, während der andere Datenträger die abgefragten Daten aus den Datenbankdateien liest.
Wie weiter oben im Theoriekapitel schon gelernt, speichern RedoLogs Änderungen an der datenbank, bevor diese in die Datendateien auf der festplatte geschribeen werden. Die Änderungen bleiben so lange in den Redo-Logs, bis ein sogeannnter Checkpoint dazu führt, dass die Änderungen in die Datendateien geschrieben und aus den RedoLogs gelöscht werden. Das sequentielle Ablegen der Änderungen in den RedoLogs passiert wesentlich schneller als das sofortige Ablegen in den Datendateien zustande klommen würden. Dies ist gut für die Performance und verkürzt auch den Zeitraum, in dem Änderungen an der Datenbank während des schreibvorgangs verloren gehen können, wenn das System mal abstürzt. Die Oracle-Datenbank wählt dann selbständig einen geeigneten Zeitpunkt für einen Checkpoint, in dem es dann die Änderungen in die Datendateien schreibt. Stürzt das System währenddessen ab, gibt es immer noch die RedoLogs, aus denen die Änderungen wiedergewonnen werden, sobald man das System neu startet. Danach kann ein erneuter Versuch unternommen werden, die Änderungen in den RedoLogs in die Datendateien zu schreiben.
Soweit so gut. Jedoch existiert die Gefahr, dass die Änderungen verloren gehen, wenn mit den RedoLogs etwas passiert. Stellen Sei sich vor, Ihr RedoLog enthält zurzeit über 500 geänderte Datensätze, die noch nicht in die Datendateien und somit noch nicht fest in die Datenbank geschrieben wurden. Wenn jetzt das RedoLog irgendwie aus versehen durch einen Datenfehler auf dem Datenträger korrupt oder gelöscht wird, haben Sie jede menge Transaktionen verloren.
Eine erste Maßnahme, um diesen Verlust zu verhindern ist, zwei Dateien von RedoLogs parallel schreiben zu lassen. Das bedeuetet, es wird zunächst ein REdoLog geschrieben, und nachdem der Schreibvorgang für dieses RedoLog abgearbeitet wurde, wird eine Spiegelung angelegt. Wenn nun eine der beiden RedoLog-Dateien beschädigt wird, ist immer noch die jeweils andere Version vorhanden. Erkennt die Oracle-Instanz, dass eine der beiden RedoLog-Dateien korrupt ist, wird sofort aus der noch funktionstüchtigen eine erneute Spiegelung erzeugt. Wird nun erneut eine Änderung an der Datenbank durchgefürht, beispeislweise ein weiterer Datensatz geänder,t dann wird zunächst das eine RedoLog aktualisiert und erst wenn der Schreibvorgang für dieses RedoLog abgeschlossen und die Datei weiterhin lesbar ist, wird die Änderung auf die zweite RedoLog-Datei übernommen. So geht im Fall der fälle, beispieslweise wenn das System während des Schrebivorgangs eines RedoLogs abstürzt, immer nur eine geringe Anzahl von Transaktionen verloren, da immer eine der beiden RedoLog-Versionen aktuell nicht beschrieben wird und unbeschädigt bleibt. Der Oralce Arhcvieurngsprozess kümmert sich darum, dass immer die gerade nicht beschriebene RedoLog-Datei in ein Archvierungsverzeichnis geschrieben wird, damti immer ein Backup der redoLogs vorhanden ist, auch wenn das System abstürzt.
Beim Anlegen einer RedoLog-Datei müssen Sie immer deren Größe angeben. Diese Entscheidung sollten Sie mit sorgfalt wählen, denn jedesmal, wenn eine RedoLog-Datei voll ist, wird ein Checkpoint initiiert und die Änderungen werden auf die Datendateien auf der Festplatte geschrieben, damit das RedoLog wieder geleert werden kann. Wenn sie die datei groß wählen, haben Sie seltener checkpoints, was dazu führt, dass ihr System bei einer hohen Transaktionslast stabiler läuft. Dafür dauert das Lesen der RedoLogs beim Systemstart länger als das Lesen der Datendateien, was heißt dass ihre Oracle-Instanz länger zum Starten braucht. Außerdem haben Sie ein höheres Risiko für Datenverlust, wenn einmal aus welchem Grund auch immer sämtliche Redo-Log-Gruppen verloren gehen würden. je größer die REdoLog-Gruppe, desto mehr Transaktion enthält sie und desto mehr Transaktionen gehen dann auch verloren.
Nun haben wir zwei REdo-log-Dateien, die in einer Gruppe wechselseitig geschrieben und archiviert werden. Die RedoLog-Datei, die gerade nicht beschrieben wird, wird archiviert, bevor Sie die Änderungen der neu beschriebenen Datei übernimmt. Diese beiden Dateien sollten auf jeweils unterschiedlichen Datenträgern liegen, so dass der Absturz eines Datenträgers nicht dazu führt, dass die Mirror-kopie des RedoLogs ebenfalls abhanden kommt. Desweiteren verbessert dies die Perforamnce, da ein Datenträger mit dem Archivieren des einen RedoLogs und ein anderer nur mit dem schreiben des RedoLogs beschäftigt ist.
Als zweite Maßnhame erstellen wir nun mehrere solcher Zweiergruppen aus Redo-Log-Dateien, die jeweils wiederum auf verschiedneen Datenträgern liegen. Eine optimale konfiguration sieht also so aus. Dadurch ermöglichen wir, dass gerade eine redolog gruppe im wechsel geschrieben werden kann (wie wir es oben bereits erälutert haben), während ältere redologs in einer anderen gruppe gerade in die datendateien weggesichert werden, weil die Dateien voll sind oder aus einem anderen Grund ein Checkpoint ausgelöst wurde.
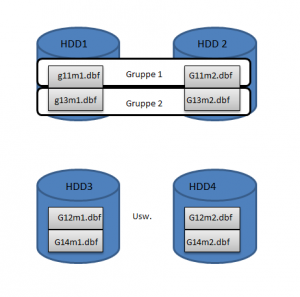
Sie können sich beispielsweise vorstellen, dass gerade die Gruppe aus G12m1.dbf und G12m2.dbf im Wechsel mit aktuellen Änderungen in den Tabellenblöcken beschrieben wird, während die RedoLogGruppe bestehend aus G11m1.dbf und G11m2.dbf gerade in die datenbankdateien geschrieben werden, weil sie voll gelaufen sind.
Hier, ohne sie abschrecken zu wollen, ein bisschen Praxis, falls Sie zu diesem Beitrag zurückkehren:
Sie können sich auf Ihrem System ansehen, wie der Status der Redologs ist
select group#, sequence#, bytes, status from v$log;
Die Speciherorte der Lgofiles kreigen Sien über die Tabelle V$logfile
Neue Redologgruppen fügen Sie foglendermaßen hinzu
alter database add logfile group 4 '/volume1/redo_4_1.log' SIZE 50M;
Und eine Datei zu einer Redo-Log-Gruppe können Sie so hinzufügen
alter database add logfile member '/volume2/redo_4_2.log' to group 4;
Den Speciherort eines Redologs ändern Sei foglendermaßen
alter database rename file '/oracle/oracle/product/<version>/oradata/orcl/redo01log' to '/volume1/redo_1_1.log';
Diese Datei darf aber gerade nicht in Benutzung sein, was Sie wie weiter oben bereits erwähnt über die tabelle V$log abfragen können. Desweiterne msüsen Sei die Datei auf Betirebssytemebene noch an den neuen Bestimmungsort kopieren und die zugriffsrechte richtig setzen.
Checkpoint
Wie bereits wieter oben schon erklärt führt ein Checkpoint dazu, dass die Änderungen an den Tabellenblöcken, die sich im Arbeitsspeicher befinden, in die Datenbankdateien geschrieben werden. Dabei bevorzugt der sogeannnte Database Writer prozess zunächst, die Änderungen aus dem Database Buffer Cache in die datenbankdateien zu schreiben, indem er die Dirty List zu Hilfe nimmt. Ist die Dirty List leer oder ist die Oracle-Instanz zuvor abgestürzt, bedient sich der Database Writer der Redo-Logs, die wenn schon nicht im Redo-Log-Puffer, dann aber als Redo-Log-Dateien auf der festplatte vorhanden sein sollten.
Ein Checkpoint kann zum einen manuell durch den User ausgeführt werden, das werden wir in der Praxis aber nru sehr sehr selten veranlassen.
Auf jeden Fall MUSS ein Checkpoint erfolgen, wenn alle Redo-Log-Dateien vollgeschrieben sind und wenn jetzt als nächstes damit begonnen werden würde, eine vollgeschriebene Redo-Log-Datei neu zu überschreiben. Deswegen initiiert die Oracle-Instanz zu einem solchen Zeitpunkt zwanghaft einen Checkpoint.
Immer, wenn ein Checkpoint dazu führt, dass Änderungen in die datnebankdateien geschrieben werden, wird die sogenannte System Change Number der letzten Änderung in die header der Datenbankdateien und in die Kontrolldatei schreibt. Somit weiß die Oralce-Instanz immer, auf welchem Stand sich die Datenbank gerade befindet und somit wird beispielsweise verhindert, dass veraltete Redo-Logs, die aus Versehen durch einen Admnistrator zurückkopiert werden, erneut in die datenbank geschrieben werden.
Commit
Ein Commit ist nicht zu verwechseln mit einem Checkpoint. Ein Commit wird jedesmal automatisch ausgeführt, sobald eine Transaktion abgeschlossen wurde. Nachdem eien Transaktion abgeschlossen wurde sorgt ein Commit dafür, dass die Änderungen an den Daten, die nach einer Transaktion in den Redo Log Buffer geschrieben werden, in die Redo Log Files auf die Festplatte geschrieben werden, so dass die Änderungen bei einem Systemabsturz nicht verloren gehen und aus den Redo Log Files wiederhergestellt werden können.
Der Unterschied ist also: Ein Checkpoint führt dazu, dass die Tabellenblöcke aus dem Databsae Buffer Cache in die Datenbankdateien auf der festplatte geschrieben werden, und ein Commit führt dazu, dass die Änderungen im Redo Log Buffer in die Redo Log Files geschrieben werden. Ein commit wird wesentlich häufiger ausgelöst als ein Checkpoint und soll dazu führen, dass Änderungen am Datenbestand der datenbank so früh wie möglich ihren platz auf die festplatte finden, ohne dabei dei Performance des Systems großartig einzuschränken.
Wie auch einen Checkpoint kann man einen Commit manuell über die KOmmandozeile auslösen, indem man einfach das SQL*Plus-Kommando commit eingibt.
Das Data Dictionary
Das Data Dictionary ist eine Sammlung von Tabellen und Ansichten (Views), die die Datenbank beschreiben. Das data Dictionary speichert die Metadaten der Datenbank, beschreibt also verschiedene Eigenschaften der Datenbank. Das Data dictionary wird als Datendatei auf der festplatte gespeichert.
Tablespaces
Da die Daten der Datenbank letztendlich auf einem Datenträger wie einer Festplatte gespeichert werdne, kann es wie bei allen anderen Datena cuh zu Fragmentierung kommen, die zu Performanceienbußen führt. Es wäre ideal, wenn die daten eienr tabelle hintereinander auf einem speziellen Bereich eines datenträgers gepecihert wrüden. Damti das funktoniert, muss ein bestimmter Bereich afu einer platte dafür reserviert werden – und man muss dazu im voraus wissen, wie groß dieser Bereich auf der platte ungefähr sein wird. Es aht sich in der Praxis bewährt, für jede Tabelle einen solchen paltz zu reservieren, was heißt, dass man für jede Tabelle ungefähr deren Größe wissen muss. is tder Platz zu klein bewertet, kann man irgendwann keine neuen Daten mehr speichern. istn er groß zu bewertet, dauert es länger, bis Daten abgerufen und aktualsieirt werden können.
Ein Tablespace ist KEINE Datei, die für das Betriebssystem sichtbar ist. Ein Tablespace ist ein logischer container für Datenbankdateien. Ein Tablespace existiert nicht auf dem Dateisystem, sondern innerhalb des Data Dictionarys. Ein Tablespace sortiert also Datendateien nach bestimmten Kriterien, um wie oben angesprochen eine bessere Performance zu gewährleisten, aber auch eine einfachere Verwaltung verschiedener Datendateien. Damit ist es beispeilsweise möglich, den Tablespace, der anwendungskritische Daten trägt, auf einem anderen, schnelleren Datenträger zu speichern als die Datendateien, welche System-metainformationen enthalten, die weniger oft abgefragt werden. Dank dem Konzept der Tablespaces müssen die Datendateien einer Oracle-Datenbank also nicht zusammen innerhalb des selben Ordners oder datenträgers liegen, sondern können verstreut sein.
Ein Tablespace kann ein oder mehrere Datendateien umfassen, jedoch kann eine Datendatei immer nur zu maximal einem Tablespace gehören.
Deswegen hat Oracle die sogeannnten Tabelspaces eingeführt. Für wachsende Tabellen werden dynamisch neue Bereiche angefordert, wenn der reservierte Bereich auf einer Festplatte zu klein zu werden droht. Desweiteren können Datenbank dateien über mehrere datenträger hinweg gebündelt werden, so dass eine Datenbank über mehrere Datenträger hinweg wachsen kann. Wird der speicherplatz einmal knapp, kann einfach ein zustäzlicher Datenträger hinzugefügt werden. Desweiteren können einzelne Tabellen ohne großen Aufwand gesichert werden, ohne dass gleich ein gesamtes Datenbankbackup durcgeführt werden muss, welches unter Umständen wesentlcih länger dauert. Alle vorhandenen Tabelspaces werden im oracle Data Dictionary gespeichert. sie können abgerufen werden über
SQL>select * from user_tablespaces;
Mit folgender Abrage kann man feststellen, welche Datenbankdateien zu welchem Tablespace gehören.
SQL>select file_name, tablespace_name, bytes, blcoks from dba_data_files;
Neben der manuellen Verwlatung der tablespaces durhc den Administrator kann man auch sogenannte Dictionary amanged Tabelspaces erstellen, die halbautomatisch durch das Oracle Data Dictionary verwaltet werden. Desweiteren kann die Oralce Instanz selsbt die Tablespaces verwalten, das nennt man dann Locally amanged Tablespaces. Diese letzte Option ist performante,r weil Änderungen an der Datenbank nicht gleichzeitig zu Änderungen am Data dictionary führen.
sie können einen Tabelspace, wenn sein platz droht voll zu werden, entweder manuell vergrößern
alter database datafile '<dateiname>.dbf' resize 1000M;
oder alternativ automatisch durch das DBMS selber vergörßern lassen.
alter database datafile '<dateiname>.dbf' autoextent on;

alter database datafile '<dateianem.dbf>' autoextent unlimited;

alter database datafile '<dateiname>.dbf' autoextend maxisze(20M);
Der nachteil bei autoextent ist, dann wenn Sie wie oben die unbegrenzte erweiterung des tablespaces zulassen, dass das DBMS den TAbelspaces so lange vergrößern kann, bis die Festplatte vollgeschrieben ist. Dadurch legen Sie dann ihr System lahm. Deswegen müssen Sie immer wieder den freien Speicherplatz auf der Festplatte im Blick haben, wenn Sie das autoextent-Feature anschalten.
Als letzte Alterantive können Sie einen Tablespace vergröern, indem sie ihm zusätzliche Datendateien zuordnen.
alter tablespace users

add datafile '<dateiname>.dbf' size 700M;
Einem Tablespace kann theoretisch keine einzige Tabelle, in der Praxis jedoch immer eine oder mehrere Tabellen zugeordnet sein. sie können acuh nachträglich neue Tabellen einem bestehenden Tabelspace zuweisen. Wie wir bereits geklrät haben, werden die Daten in einem tablespace hintereinader auf einem reservierten Speichersegment auf der festplatte geschrieben, damit kenie Formatierungauftritt. Ein reserviertes Segment nennt man auch Extent. Die extents werden zwar hintereinander auf die Festplatte geschrieben werden, können aber auf mehrere .dbf-Dateien im Dateisystem verstreut sein. Wenn sie einen TAbelspace das erste mal anlegen, weißen Sie diesem einen sogeannnten Basis-Extent zu. Dieser sollte idealerweise genau die Größe der tabellen haben, die auf diesem Tabelsapce leigen. Das bedeutet, es gibt nciht zu wenig, aber auch nicht zu viel Speicherplatz, der dem Extent zugeordnet wurde. Diesen basis-Extent können Sie bei einer stetig wachsenden TAbelle um weitere Next-Extents vergrößern, immer wieder, bis theoretisch die Festplatte voll ist, auf welcher der Tablespace liegt.
In den bisherigen Varainten wird die Größe der tabelspaces über das Data Dictionary verwaltet. Jedesmal, wenn Sie einen Tablsepace verändern, wird das Data Dictionary mit belastet. Wie wir aber gelernt haben, ist es auch möglich, einen Locally Managed Tablespace anzulegen. mit folgendem Statement erstellen Sie beispielsweise einen LMTS mit Ausgangsgröeß 100 MB, , der automatishc durhc das system vergörßert wird und maximal auf 500 MB anwachsen kann.
create tablespace user_m

datafile '<dateiname>.dbf' size 100M

autoextend on maxsize 500M

extent management local autoallocate;
Nun wird die Größe des Tablespaces nciht mehr im Data Dictionary, sondern lokal innerhalb der Datendateien verwaltet.
System Tablespace
Enthält das Data Dictionary sowie Performance Management Info und Views. Dieser Tablespace muss dauerhaft online sein, damit das system läuft.
SYSAUX Tablespace
Zusätzlicher Tablespace zu SYSTEM, der zusätzliche informationen enthält. wrude vom System-Tablespace abgespalten, um die Last auf den System-Tablespace zu verringern.
USERS tablespace
Enthält Userobjekte und Userdaten
TEMP Tablespace
Speichert Ergebnisse von Abfragen zwischen, besonders bei Queries, die mittels ORDER BY-Clause sortiert werden sollen.
Undo-Tablespace
Sie haben weiter oben bereits gelernt, dass die Oracle-Datenbank Änderungen an den Daten zunächst im Arbeitsspeicher lagert und in From von REdo-Logs sichert, um Sie später auf die Datenbankdateien zu schreiben. Dabei verfolgt oracle einen optimistschen Ansatz. Das heißt Oracle beginnt bereits damit, die geänderten Daten schon als Redo-Log oder ganz in die datenbankdateien zu schreiben, bevor die eigentliche Transaktion mit einem COMMIT abgeschlossen ist. Das heißt, die Dateien werden bereits geändert, obwohl die Transaktion aus irgendeinem Grund eventuell noch abgebrochen werden kann, weil beispielsweise ein anderer Datenbankbenutzer gerade am selben Datensatz arbeitet. Für den Fall, das sowas passiert, schreibt Oracle sogenante Undo-Einträge in einen Undo-Tablespace. Dieser ermöglicht es, im Falle einer gescheiterten Transaktion die Datensätze wieder auf den ursprungszustand zurückzufürhen. Der optimistische Ansatz von Oracle lohnt sich, weil der Großteil der Transkation erfolgreich ausgeht und dadurch mit diesem Ansatz performance gewonnen werden kann. im Detail funktioniert das so
Ändert ein Anwendner einen Datensatz, wird von diesem im Vrofeld eine kopie des Tabellenblockes im Databse Buffer cache angelegt, bevor die Änderungen durch eien Transaktion initiiert wird. Nach der Änderung befinden sich für eien gewisse Zeit einmal der Tabellenblock, der gerade durch die Transaktion geändert wird, und einmal der ursprungszustand im Database Buffer cache.
Solange die Transaktion zum Ändern des Datensatzes noch nicht abgeschlossen ist, greifen die anderen Benutzer noch auf die Kopie des ursprungszustandes zu, dem sogenannten Before-Image. Sie sehen also noch den alten Wert des Datensatzes, bis die Transkation zum Ändern durch ein COMMIT abgeschlossen wird.
Das Before-Image wird aber nicht nur gebraucht, falls die Transaktion an sich fehlschlägt, sondern wird auch gebraucht, falls der user selbst seine Transaktion rückgängig machen will, weil er etwas falsches eingegeben oder geändert hat, auch Rollback genannt. Solange das Before-Image noch existiert, kann die Oracle-Instanz und somit auch der nutzer die transaktion wieder rückgängig machen.
Genau wie die Änerungen an den Tabellenköpfen werden auch die Before-Images regelmäßig ausd em Arbeitsspeicher auf einen festgelegten Tablespace auf die festplatte geschrieben, damit sie nicht gleich verloren gehen, wenn die Oracle-Instanz einmal abstürzt. Das Before-image wird dabei in den sogenannten undo-tablespace geschrieben.
SAP-spezifische Tablespaces
Da sich dieser Blog stark mit der Administration von SAP-systemen beschäftigt, werden wir noch ein wenig auf SAp-spezifische Tablespaces eingehen.
PSAPTEMP
Temporärer Tablespalce der beispielsweise Sortieroperationen enthält
PSAPROLL oder PSAPUNDO
Tablespace für rollback-operationen.
PSAP<SchemaID>
tablespace für alle SAP-objekte udn Tabellen (ABAP)
PSAP<SchemaID>DB
Tablespace für alle SAP-objekte und Tabellen (java)
PSAP<SchemaID>USR
Tablespace für alle kundeneigenen objekte und tabellen
PSAP<SchemaID><REL>
Tablespace für alle Objekte und Daten (ABAP), die von der verwendeten SAP-produktversion abhängig sind.
Datenverteilung
aus dem bereits vermittelten Wissen ist ersichtlich, dass die verwendung von RAID-levels, die bei schreibintensiven Umgebungen zu einem Performance-Bottleneck werden können, inakzeptabel ist. Deswegen ist es eine absolute Sünde, die zugriffshäufigen bestandteile von Oracle mit den RAID-Levels 3, 4 oder 5 zu betreiben,. ebenso wie die Verwendung von Software-RAID im allgemeinen.
Ebenso haben wir bereits weiter oben abgesteckt, dass zwe aufeinanderfolgende Redo-Log-Gruppen unbedingt auf verschiedenen Plattenbereichen liegen sollten. Ebenso sollten die beiden Mitglieder einer Redo-Log-Gruppe auf verschiedenen plattenbereichen liegen.
Desweiteren sollten die Datendateien und die Redo Logs ebenso auf verschiedenen Plattenbereichen liegen, so dass bei einem Checkpoint die Schreib- und Leseperformance der Redo-Logs unangetastet bleibt. Sie soltlen desweiterne nicht mit anderen sehr ändeurngsintensiven Teilen der Datenbank zusammen auf dem selben plattenbereich vermischt werdne, etwa mit Rollback-, Undo- oder temporären Tablespaces der Datenbank.
Für die Logs sollte immer ein RAID 1 verwendet werden.
Das führt uns ungefähr zu folgender Aufteilung.
Instanz-Recovery
Wollen wir mal zusammen in der Theorie durchgehen was passiert, wenn eine Oracle-Instanz abstürzt und danach wieder neu gestartet wird? Wenn eine oracle-Isntaz abstürzt müssen alle änderungen, die beim Absturz im Datbsae buffer cache standen, erst noch auf die Festplatte übertragen werden. DAs geschieht, wie wir ja bereits wisen, über die redo logs. Der hierzu nowtendige Recovery prozess wird bei jedem Oracle-instanz-Neustart automatisch ausgeführt.
Alle Änderungen in den Redo-Log-Dateien sind vollständig durchgelaufen und werden von den Redo-Log-Dateien in die datenbankdateien geschrieben. Eventuell prüft die Instanz vorher die System Change Number in den Headern der Kontrolldatei oder der Datenbankdateien um sicherzustellen, dass keine veralteten Änderungen in die Datenbankdateien von den REdo-logs übernommen werden. Alle nicht vollständig durchgelaufenen Transaktionen werden anhand ihrer Before-Images im Undo-Tablespace zurückgerollt.
Shared Pool
Der Sahred Pool verarbeitet die SQL-anweisungen und beschleunigt so deren Ausführung. Wenn eine SQL-Anweisung an die Oracle-Isntanz geshickt wird, muss diese erst verarbeitet werden. Daz gehören die Überprüfung der Syntax, die Existenz der in der anweisung angesprochenen Objkete und der Zugriffsrechte des Anwenders auf diese objekte.
Diese Daten findet der shared Pool im Data Dictionary, welches im SYSTEM-Tablespace liegt. Oracle muss die Daten im SYSTEM-Tablespace einlesen, um die SQL-Anweisungen verabreiten zu können. Dieses Data dictionary liegt fest abgespeichert auf der Festplate, wird jedoch im lauenden Betrieb im Arbeitsspeciher gehalten. Dort liegt es in einem speziellen Bereich des Sahred pools, dem sogenannten Dictionary cache.
Im Shared pool liegt ebenfalls der sogenannte Library Cache. Dieser enthält verschiedene Ausführungspläne, die wiederum vershciedene Routinen beinhalten, um die Oracle-Datenbank nach abfragten Objekten und Werten zu durchsuchen. Die Oralce-datenbank wählt nach Analyse der SQL-Anweisung den Asuführungsplan, der vermutlich am wenigsten Zeit udn ressourcen in Anspruch nehmen wird. Der passende, von der oracle-istnazausgewhlte Ausführungsplan, wird im Library cache abgelegt. Bei erneuter Asuführung der Anweisung kann der Ausführungsplan sofort aus dem cache geladen werden.
Large Pool, Java Pool & streams Pools
Im Large pool werden diverse weitere Komponenten vorgehalten, wie etwa der Recovery Manager oder der shared Server.
Der java pool bietet die Möglichkeit, gespeicherte Prozeduren anstelle der Orcale-eigenen sprache PL/SQl in Java zu programmieren. Java-Programme benötigen eine Java Virtual machine, um laufen zu können. Diese bietet Oracle in diesem Speichebreriehc des Java Pools.
Der Streams Pool wird zur Replikation von Daten zwiscehn Davenbanken verwendet. Dabei werden die daten als Nachricht vershcickt und in Queues abgelegt. Diese Queues werden im streams Pool zwischengespeichert.
Prog Global Area (PGA)
Standardmäßig ist die Oracle instanz so konfiguriert, dass für jeden Oracle-User, der für Anfragen genutzt wird, ein eigener sogenannter PGA geschaffen wird. Für jeden dieser PGA wird ein extra Serverprozess auf Betriebssystemebene gestartet, der einen Freiraum im Arbeitsspeicher für diesen User reserviert. Hier werden user-spezifische Daten gecahed wie SQL-Code von Anfragen, die dieser User desöfteren ausführt usw.
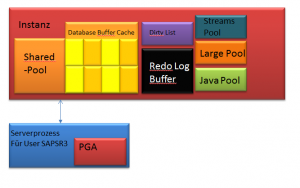
Automatic Memory Management
Jetzt, da Sie schon so viel über Oracle und seine Speicherverwaltung wissen, fragen Sie sich vielleicht, wie es ein Administrator schaffen soll, die richtigen Größen für diese ganzen Speicherbereiche zu finden?
Die Gute Nachricht ist: Für die meisten Szenarien reicht das Automatic Memory Management von Oracle, welches auf Basis von Erfahrungswerten im laufenden Betrieb die Größen dieser verschiedenen Speicherpools dynamisch anpasst.
sie können scih die aktuellen Größen aller buffer anzeigen lassen mit
SELECT * FROM v$sga;

SELECt * FROM v$sgainfo;
Die Gesamtgröße von SGA und PGA können Sie mit dem Parameter memory_target setzen.
ALTER SYSTEM SET memory_target = 838860800 SCOPE=BOTH
Logische Speicherstrukturen
Wie wir weiter oben bereits kennengelernt haben, gibt es in Oracle physikalische speicherstrukturen, also Dateien wie beispielsweise das Control File, die Datendateien oder die Redo-Log-Dateien, die auf die festplatte geschrieben werden.
mit dem Tablespace, den wir weiter oben bereits besprochen haben, haben wir eine der sogenannten logischen Speicherstrukturen kennengelernt. Diese werden im Data Dictionary von Oracle festgelegt und helfen dabei, physikalsiche speicherstrukturen zu organisieren. Somit ist es beispielsweise möglich, dass man die Datendateien der Oracle-Datenbank über mehrere Datenträger verteilt. Dank des control Files und des Data Dictionarys, welche sich dei Pfade zu den Datendateien merken, erinnert sich die Oracle-Datenbank daran, welche Daten in einem Tablespace bei welchen Datendateien zu finden sind.
Neben dem Tablespace gibt es noch andere solcher logischer Speicherstrukturen.
Die kleinste logishce Speichereinheit ist der sogenannte Oracle Block. Es ist die logische Abbildung eines Datenclustesr auf einer physikalischen festplatte. Beispeil: Unter NTFS ist es so, dass der minimale Speicherplatz auf dem Dateisystem ein Cluster mit einer Größe von 4 KB ist. DAs heißt: selbst wenn Sie mit dem windowseditor eine Datei erstellen, die nur 1 KB groß ist, so wird diese in der theorie 1 KB-große Datei auf der festplatte 4 KB Speicherplatz wegnehmen, weil dies die kleinste verfügbare Speichermenge auf dem Dateisystem ist. Ein Oracle Block istdie entsprechung eines solchen Clusters im logischen sinne. es empfiehlt sich aus diesem Grund, die Größe der logischen Oralce Blocks an die minimale Größe solcher Datencluster auf dem physikalischen speichermedium anzupassen – oder ein Vielfaches davon zu nehmen. Einige Administratoren würden z. b. bei einer clustergröße von 4 KB hergehen und die Größe von Oracle Blocks auf 8 KB stellen, dem Zweifachen von 4KB.
Eine Gruppe von Oracle Blocks, die afu dem physikalischen Datenträger direkt nebeneinander liegen, nennt man ein Extent. Standardmäßig sind das 1 MB Große Gruppen an oracle Blocks. Wenn Sie die Größe von oracle Blocks auf 8KB gestellt haben heißt das, dass 1024 Oracle Blocks in diesem Extent drin sind. Ein Extent weißt Speicherplatz zu verschiedenen Datenbankobjekten zu. Wir ahben beispielsweise gelernt dass es möglich sit, in einem Tablespace nicht nur eine, sondern mehrere Tabellen zu verwalten. Jede Tabelle bekommt dabei einen gewissen Speicherpaltz zugewiesen. Diesen Speicherplatz weißt Oracle logisch geshen in From von einem oder mehreren Extents zu.
Jedes objekt in einem Tablespace, ob Tabelle, Index o. Sonstiges, wird in einem Segment gespeichert. Ein Segment ist eine Gruppierugn von Extents, die in ein und demselben Tablespace gespeichert sind und die einem Objekt zugewiesen wurden. Das heißt: Wenn ihr in einem Tablespace beispielsweise drei Tabellen erstellt, dann bekommt jede diese Tabellen jeweils ein Segment mit wiederum jeweils einem oder meheren zugewiesenen Extents.
Views
Ein View ist eine gespeicherte SQL-Anfrage, die ausgeführt werden kann, um bestimmte Daten aus der datenbank übersichtlich anzuzeigen. Das bedeuetet ein View ist nichts anderes als eine SQL-Anfrage, die sie auch ganz einfach selbsta usführen könnten, nur zur späteren Wiederverwendung gespeichert.
Das Data dictionary bietet viele verschiedene Views, mit der wir häufig benötigte informationen abfragen können.
Beispielsweise gibt es die Views
- User: daten über die objekte, die einem User gehören
- ALL: alle Daten und objekte, auf die derzeitig angemeldete user zurgeifen kann
- DBA: Informationen über alle Objekten in der gesamten Datenbank.
mit foglendem SQL-Code können Sie jede einzelne View aus dem Dictionary holen:
spool on

spool c:\dictionary.txt

select * from dictionary;

spool off
in der Datei C:\dictionary.txt haben Sie nun die informationen aus allen Views des Data Dictionarys.
Wichtige Dateien
Die kontrolldatei
Die kontrolldatei enthlt die Speicherorte der Datenbankdateien, oft auch als Datendateien bezeichnet. Dies sind Dateien, die im Dateisystem der Festplatte des Systems hinterlegt sind, und in denen die Daten drin stehen, die letzendlich in der Datenbank hinterlegt sind. Manchmal sind diese Datendateien direkt im Dateisystem hinterlegt und haben somit einen Dateinamen. Dann enthlt die Kontrolldatei den Pfad zu diesen Dateien im Dateisystem. Manchmal jedoch werden die Datendateien direkt „roh“ auf eine Festplatte geschrieben, ohne dass es einen Dateinamen im Dateisystem gibt, der auf diese Daten zeigt. Dann enthält die Kontrolldatei den Pfad zu dem sogenannten Raw Device, also zum reservierten Speicherbereich, der für diese Datendateien vorgesehen ist.
Nach dem Start einer Oracle-Serverinstanz schaut diese in den Parameterdateien nach, wo sich die Kontrolldatei befindet. Die Serverinstanz öffnet die Kontrolldatei und sieht nach, wos ich die Datenbankdateien befinden. Daraufhin bindet die Oracle-instanz die Datenbankdateien an (man spricht auch vom mounten einer Datenbank) und ermöglicht somit den Zugriff auf die Datenbanken, die sich hinter diesen Datenbankdateien verbergen.
Neben den Pfaden zu den Datenbankdateien steht in der Kontrolldatei außerdem der Sicherungskatalog des recovery Managers. Das bedeutet die Kontrolldatei enthält ein Logbuch mit den wichtigsten Daten über alle erfolgten Sicherungen der Datenbank.
Ohne die Kontrolldatei weiß die Oracle-Serverinstanz nicht mehr, wo sich die Datenbankdateien befinden. Das heißt ohne Kontrolldatei funktioniert auch die Datenbank nicht. man aknn zwar versuchen, manuell eine Kontrolldatei zu erzeugen und die Datenbankdteien selber wiederzufinden, das ist jedoch mit enormem Aufwand verbunden. Deswegen wird die Kontrolldatei im laufenden Betrieb gespiegelt, so dass falls diese mal versehentlich gelöscht wird im laufendne Betirb wiederhergestellt werden kann und die Oracle-Datenbank weiterhin funktioniert. Und desweiteren wird die Kontrolldatei bei jedem Backup der Datenbank mitgesichert.
Weil die kontrolldatei so wichtig ist, wird diese genau wie die Redologs gespiegelt und zyklisch (also im Wechsel) auf die Festplatte geschrieben, während die andere Datei als Backup zur Verfügung steht. Grundsätzlich sit es deswegen, wie auch bei den RedoLogs, empfohlen, die beiden Kontrolldateien auf zwei verschiedenen Datenträgern vorzuhalten.
Paramaterdateien
Parameter der Oracle-Instanz können einmal im Oldschool PFILE und einmal im SPFILE gespeichert werden.
Soweit möglich, sollten Sie Änderungen immer über das SPFILE machen. Denn bei diesem handelt es sich um eine dynamische Datei, die im laufenden Betrieb geändert werden kann. Wenn sie Änderungen an Parametern übernehmen wollen, die im PFILE eingeben wurden, müssen Sie hingegen die Oracle-Instanz neu durchstarten. Desweitreen können Sei das SPFILE im Gegensatz zum dem PFILE zwischen mehreren in einem Cluster verbundenen oracle-Isntanzen teilen, so dass alle die selbe SPFILE-Datei verwenden.
Das SPFILE ist keine Textdatei, die Sie mit einem Texteditor bearbeiten können, sondern eine Binärdatei. Ändern können Sie die Parameterüber den SQLPlus-Command alter system set. DAs ältere PFILE hingegen können Sie durchaus mit einem Texteditor bearbeiten.
die Parameterdatei enthält außerdem den Pfad zum Control File, dessen Wichtigkeit wir ja weiter oben bereits erwähnt haben.
Wie speichert eine oracle Datenbank Änderungen
sie wissen vielleicht von anderen Datenbankmanagementsystemen, dass die Datenbanken immer an zwei Orten gehalten werden: Im Arbeitsspeicher des Systems und auf der Festplatte. Auf der festplatte werden die Daten gespeichert, so dass wenn der Server einmal neu gestaretet wird oder abstürzt, die Datenbank auf der Festplatte immer noch gespeichert ist und von dieser wieder gelesen werden kann. Im laufenden Betrieb der Datenbank dauert es jedoch sehr lange, wenn alle Daten jedes mal von der festplatte gelesen werden müssten. Die Anwender würden hierbei eine wahrnehmbare Verzögerung spüren, weil es jedesmal ein paar Sekunden dauern würde, bis die Daten aus der Datenbank angezeigt werden. Um dies zu verhindern, werden häufig angefragte Daten im Arbeitsspeicher vorgehalten. Wenn Sie an eienr Datenbank etwas ändern – etwa einen Datensatz hinzufügen oder einen bestehenden ändern, werden diese Änderungen ebenfalls zunächst in den Arbeitsspeicher geschrieben, weil dies wesentlich schneller geht. im Hintergrund werden die Änderungen dann auf die Festplatte geschrieben. Das birgt grundsätzlich das Problem, dass in der Zeit, in welcher die Daten vom Arbeitsspeciher auf die Festplatte kopiert werden, dass der Server in diesem Zeitraum abraucht und die Änderungen verloren gehen.
Eine Oracle Datenbank arbeitet hier noch mit einigen Besonderheiten. Auch hier werden häufig abgefragte Daten sowie Änderungen zunächst im Arbeitssepicher vorgehalten. Die Oracle-Datenbank schreibt jedoch fortlaufend sogenannte Redo-Logs. Das heißt immer dann, wenn Sie eine Änderung in der Datenbank machen, wird im Arbeitssepciher eine Datei geschrieben, welche diese Änderungen enthält. Der Log-Writer-Prozess der Oracle-Instanz schreibt diese Änderung dann sofort in eine Datei auf der festplatte weg. Das geht wesentlich schneller, als würde der Serverprozess erst die gesamte Datenbank auf der Festplatte einlesen und dann die Änderung an der richtigen Stelle editieren bzw. einfügen. Dadurch ist der Zeitraum, in welchem Daten verloren gehen können, wesentlich kürzer, weil die Redo-Log-Dateien wesentlich schneller geschrieben sind als bei herkömmlichen Datenbanken, welche die Änderungen einfach so auf die Datendateien der Datenbank schreiben. Nach und nach versucht auch die Oracle-Instanz, Änderungen auf die Datendateien der Datenbank zu schreiben, um den Pufferspeicher im Arbeitsspeicher des Servers sauber und frei zu halten. Jedoch kann hier nichts mehr passieren, wenn in diesem Zeitraum der Server abraucht, weil ja noch die Redo-Logs vorhanden sind, falls etwas passieren sollte. oracle reserviert Tablespaces für wirklich ALLES. Sogar für die Zwischenergebnsise von Berechnungen, Hash-Operationen und Gruppierungen gibt es sogenannte temporäre Tablespaces.
Oracle und die Raw Devices
Von anderen Datenbankmanagementsystemen wie mySQL unter der Storage Engine InnoDB ist Ihnen vielleicht bekannt, dass Datenbanken die oben erwähnten Datendateien, also die auf der Festplatte gespeicherte Datenbank, als simple Dateien abspeichert. Wenn Sie diese Dateien auf einen externen Datenträger wegsichern, haben sie dann de fakto eine Sicherungskopie Ihrer Datenbank zum Zeitpunkt der Kopie, da diese Dateien dann sozusagen die inhalte der datenbank wiederspiegeln.
Dies hat jedoch Performancenachteile, weil das Betriebssystem erst die entsprechenden Dateien im Dateisystem erzeugen und verwalten muss. Desweiteren werden die Daten dann erst in den Schreibcache des Betriebssystems kopiert, bevor sie dann von diesme Schreibcache an die Festlatte „gesendet“ und dann von dieser geschrieben werden.
Wesentlich schneller und daher performanter wäre es, die Daten für die datenbank direkt als Bits und Bytes auf die Festplatte zu schreiben, ohne dass diese als Dateien im Dateisystem sichtbar bleiben. Der Vorteil ist die dadurch bessere Performance, da die Schreib- und Lesevorgänge direkt vom Betriebssystem zur Festplatte gehen und nicht erst den Umweg über das Dateisystem und den Betriebssystem-Schreibcache gehen müssen. Oracle hat nämlich selbst bereits einen Caching-Algorithmus integriert, wie wir später noch lernen werden. Diese beiden Caching-Algorithmen von Oracle und Betriebssystem sind sozusagen doppelt gemoppelt und können sich auch gegenseitig behindern. der Nachteil ist, dass Sie die Datenbankdateien nicht mehr als Datei im Dateisystem finden und daher nur noch über die datenbankinternen Methoden eine Sicherung der Datenbank anlegen können. Und selbstverständlich müssen Sei als Administrator sich darum kümmern, dass eben jener Bereich auf der Festplatte, auf den die rohen Datenbankdateien für die Datenbank geschrieben werden, nicht vom Dateisystem verwendet wird, um dort gewöhnliche Dateien drüberzuschreiben, da dies die Datenbankdateien ja zerstören würde.
Unter Linux/Unix-Systemen verwendete man dazu lange sogenannte Raw-Devices. Raw-Devices sind also „virtuelle Geräte“, die einen bestimmten Bereich auf einem Speichermedium wie einer Festplatte oder einer SSD markieren, auf dem das Dateisystem nicht fungieren soll, sondern wo die Dateien direkt als Bits und Bytes auf die Festplatte geschrieben werden, ohne dass diesen Daten ein Dateiname oder Ähnliches zugeordnet wird.
Mittlerweile gibt es eine Alterantive zur nutzung von Raw Devices. Oracle erstellt auf den Geräten dann ein eigenes Dateisystem namens Automatic storage Management. Dei Geräte stehen dann dem Betriebssystem nicht mehr zur Verfügung – sondern nur noch der Oralce-Instanz, sodass die Verwendung des Betriebssystem-Caches übergangen wird. Oracle kümmert sich dann selsbt um typische Funktionen, die man vielleicht vom Betriebssystem erwarten würde, etwa das Striping zum Verteilen der Daten auf mehrere Geräte (typische RAID-1-Funktionalität), oder das Verschieben der Daten von einer sterbenden platte auf eine zweite platte, die noch funktioniert, sowie um den Lastausgleich der Lese- und Schreibzugriffe zwischen mehreren Geräten.
Objektorientierung
Oracle wird als eine objektorientiertes relationales Datenbankmanagementsystem bezeichnet, weil es die prinzipiellen relationaler Datenbankmanagementsystem in eine objektorientiertes Datenmodell ummünzt. Das heißt im Klartext, dass Objekte, User, Tablespaces usw. als Objekte mit verschiedenen Eigenschaften beschrieben sind. Der Vorteil dieser objektorientierten Verhaltnsweise ist, dass man gleichartige Objekte, die nur wenige unterscheidende Merkmale haben, in Klassen zusammenfassen kann, was Arbeit beim definieren verschiedener gleichartiger Objekte spart, da sie viele gemeinsame Eigenschaften haben, die sie miteinander teilen.
Wenn Sie mehr über das objektorientierte datenmodell wissen wollen, sollte Sie sich mit einer Programmiersprache Ihrer Wahl mit objektorientierte Programmierung auseinandersetzen.
die Prozesse
Eine Oracle-Instnaz besteht dabei aus mehreren SErvernprozessen oracle<dbsid>. Diese gehören allesamt dem User <dbsid>adm. DAnn gibt es noch andere Prozesse
- ora_pmon. process monitor. Zuständig für das Monitoring von Server- und Userprozessen und dem Erkennen von Problemen.
- ora_dbwr / ora_dbw<n> – Database Writer. Schreibt regelmäßig im Hintergrund frisch geänderte, im Hautpspeicher befindliche Daten auf die Festplatte, damit Sie dauerhaft gespeichert sind.
- ora_lgwr – log-Writer. Schreibt die sogeannnten RedoLogs aus dem Log Buffer in die redoLog-Files
- ora_ckpt – Checkpointer. Erzwingt unter bestimmten Voraussetzungen einen Checkpoint und schreibt somit RedoLogs aus dem Hauptspceicher auf die Festplatte.
- ora_smon – System monitor. Zuständig für das Mounten Öffnen und Schließen der Datenbank und für die zuordnung von freiem Speciherplatz zu Datennbankdateien.
- ora_reco – Recovery
- ora-ARCH – Archiver. Archiviert die Redo-logs in ein Archiverzeichnis.
- ora_lck – Lock Process
- ora_snpn – Snapshot
- ora_mmon – statistiken für das workload repository
- ora_mman – Memory manager
- ora_rkwr – Recovery Writer
- ora_pspo – Starten von prozessen.
Im Gegensatz zu SAP-prozessen haben die Oracle-hintergrundprozesse keinen zugeordneten Vaterprozess. Da die sqlplus-Session, die benutzt wird, um die Oracle-Instanz über das kommando startup zu starten, nach dem Ausloggen wider terminiert wird, kann sich nciht ls Vaterprozess für die oben geannten prozesse dienenl. Daher werden die prozesse unter Unix an den zentralen unix-Prozesse init mit der PID 1 angehängt.
Zusammenfassung
Wollen wir mal zusammen den Start einer Oracle Datenbank durchgehen? Na dann alles klar:
Als erstes wird der Oracle Dienst gestartet. Dieser ist meistens auf Betriebssystemeebene auf Autostart gestellt, das heißt sowohl unter Windows als auch unter Linux/Unix läuft der Oracle Service/Daemon gleich nach Start des Betriebssystems. Mit diesem service/Daemon wird das sogenannte RDBMS, also das Datenbankmanagementsystem (oracle.exe), aber noch nicht die Instanz und auch noch nicht die Datenbank zur Verfügung gestellt.
Nun wollen wir ja natürlich irgendwie erstmal die Oracle Instanz starten. Damit das geht, muss das RDBMS irgendwie Anfragen zum STarten der instanz per Netzwerk entgegennehmen können. Deswegen muss der Listener Service/Daemon gestartet werden, damit die Oracle Datenbank diese Anfrage empfangen kann und daraufhin die Oracle-Instanz startet. erst wenn der Lsitener läuft, kann das RDBMS eine Anfrage zum Starten der Instanz entgegennehmen, die wir beispielsweise in sql*plus über startup open anfragen könnten.
Das Starten der Instanz passiert natürlich nicht einfach so. Denn wie wir ja gelernt haben, brauchen wir ja erstmal das Control File. Und der Standort zum Control File wiederum steht im SPFILE / PFILE, wo auch die anderen Parameter drin stehen, die zum STarten der instanz notwendig sind.
Erst jetzt, wenn das RDBMS die zugehörige Parameter- und Kontrolldatei zur Instanz gefunden hat, wird die Oracle-Instanz an sich gestartet. Dazu wird der notwendige Speicherplatz für die SGA und PGA im Arbeitsspeicher reserviert, die anderen nowtendigen Prozesse wie DBWR, LOGWR usw. werden gestartet. Jetzt überspringen wir der Einfachheit halber mal ein paar Schritte und gehen davon aus, dass die Oracle-Instanz läuft. Dann sieht das ganze so aus
Während die Datenbank läuft, geschieht nun eine Änderung in der Datenbank. Wie wir gelernt haben, wird diese Änderung zunächst in die Tabellenblöcke des Databse Bufer Caches übertragen.
Diese Änderung wird auch in den Redo Log Buffer übertragen.
Noch hilft uns das ganze aber nichts, denn wenn jetzt das System abraucht, geht der inhalt im Arbeitsspeicher verloren – und damit letztendlich auch die Änderungen in der Datenbank, da die Änderungen sich noch nicht auf der festplatte befinden. Deswegen ist das erste, was die Oracle-instanz macht, diese Änderungen in die Redo Log Dateien zu schreiben, wie wir ja wissen. Und erst, wenn die Änderungen in diesen Redo-Log-Dateien gelandet sind, ist die Transaktion abgeschlossen und die Änderungen ist letztendlich von usern „abrufbar“, wenn diese eine Query an die Datenbank starten, da erst ab diesem Zeitpunkt gewährleistet ist, dass die Änderung auch bestehen bleibt, wenn das System abstürzt. Da also gewährleistet ist, dass die Daten nicht wieder verändert werden, bis sie auf der festplatte sind, spricht man von einer synchronen Übertraugng der Änderungen
Was passiert, wenn jetzt der Server abschmiert, werden einige von euch fragen. Dazu müssen wir erst nochmal das Konzept der System Change Number in die Grafik einbauen.
Die System Change Number zeigt dem oracle-System an, auf welchem Stand es sich derzeit befindet. Die Datendateien unserer Datenbank enthalten derzeit die Daten ohne den Change und haben aber eine bestimmte SCN.
Da wir jedoch einen change haben, muss eine aktualisierte SCN irgendwo abgespeichert werden. Da unsere Datendateien den Change derzeit noch nicht empfangen haben, ist der einzig logische speicherort für die neue SCN in den Redo Logs. Diese neue SCN muss auch in die Kontrolldateien wandern. Warum, sehen wir gleich.
Jetzt lassen wir den Server an dieser Stelle einmal abstürzen. Wir starten das Serversystem und die Oracle instanz neu. Das RDBMS schaut wieder in das SPFILE, wo die Kontrolldateien liegen und merkt beim Starten der Instanz, dass die SCN-Nummer in den Kontrolldateien eins höher ist als die SCN in den Datendateien. Das heißt: das System weiß jetzt, dass es Änderungen im Vergleich zum derzeitigen Stand der Datendateien gibt. Und der einzige Ort, an dem diese Änderungen liegen können, sind die Redo Logs. Also schnappt sich das RDBMS die redo Logs und schaut nach, welche Änderungen ab dem Wert <SCN+1> vorgenommen wurden und schreibt diese Änderungen in die Datendateien. Danach werden die SCNs auf den gleichen Stand gebracht und die Datenbank ist auf dem aktuellen Stand.
Gut, dann läuft unser Server erstmal wieder und alles ist auf dem aktuellen Stand:
Was ist jetzt, wenn mal eines der Redo Logs vollgeschrieben ist? Redo Log-Dateien haben ja eine vordefinierte Größe, nach der diese voll werden. Nehmen wir mal an, seit der letzten Aktualisierung der Datendateien wurden 20 Changes durchgeführt, und beim 19. Change läuft eine Redo Log Datei voll. Dann wird einfach eine neue Redo Log Datei angefangen und die vollgelaufene Redo Log Datei wird nebenbei als Archive Log archiviert.
Wenn die Archivierung fertig ist, wird das vollgelaufene Redo Log wieder geleert und steht wieder für einen neuen Schreibvorgang zur Verfügung.
In einigen Fällen, wenn man die Größe der Redo Log Files falsch gewählt hat, kann es jedoch vor kommen, dass das erste vollgeschriebene Redo Logn noch archiviert ist, als das letzte Redo Log File vollgeschrieben wurde.
Sie können es sich wahrscheinlich denken: In diesem Fall steht das System komplett still. Das bedeutet: Es ist solange keine Änderung möglich, bis wieder eine leere Redo Log Datei zur Verfügung steht. Diesen Fehelr quittiert Ihnen das oracle RDBMS oft mti der meldung ARCHIVER_STUCK. Diesen Fehelr können Sie vermeiden, indem Sie die Redo Logs so dimensionieren, dass Sie nicht voll werden, während noch eines archiviert wird, also beispieslweise eine weitere redo Log Datei hinzufügen. Oder sie können den Archivierungsprozess beschelunigen, indem Sie beispielsweise die Redo Log Dateien wie bereits besprochen auf unterschiedliche Datenträger aufteilen oder beispeislweise schnellere Datenträgermedien verwenden.
Wie läuft das jetzt, wenn wir ein Backup von unserer Datenbank machen wollen? Nun, bei einem sogenannten Offline-Backup, bei welchem die Oracle-istnanz vor dem Backup heruntergefahren wird, ist es reht einfach. Hierbei wird in der Regel einfach ein sogenannter Checkpoint initiiert und alle Änderungen im Database Buffer Cache werden auf die Datendateien übertragen.
Hierbei würde die Oracle-Instanz beim hochfahren erkennen, dass die SCN der Kontrolldateien und die SCN der Datendateien gleich sind und daher die gespeicherten Changes in den Redo Logs und Archive Logs ignorieren, da diese maxiaml gleich alt sind mit den Änderungen in den Datendateien. Eventuell werden die Redo Logs und die Archive Logs nach einer gewissen Zeit geleert, so dass keine überflüssigen Änderungen mehr in den Logs gespeichert werden, die sich bereits in den Datendateien befinden. Sie sehen, das einzige, was Sie theoretisch backupen müssten, wären die Datendateien und die Kontrolldateien. Die REdo Logs und die Archive Logs brauchen Sie nicht, solange beim Checkpoint alle Änderungen sauber in die Datendateien geschrieben werden.
Komplizierter wird die ganze Angelegenheit bei einem sogenannten Online-Backup. Hier läuft die Oracle-Instanz weiter, während im laufenden Betrieb das Backup durchgeführt wird.
Was Sie bei einem Online-Backup überhaupt nicht wollen, ist folgendes Szenario:
Sie machen ein Backup und sichern gerade Ihre Datendateien weg, sagen wir mal, Sie brauchen pro Datendatei 10 Minuten und sind gerade dabei, die Datendatei zwei zu sichern.
Während des Backups kommt ein Change herein, der alle Datendateien ändert. Es ist nicht schlimm, dass Ihnen die aktuelle Version von SCN+40 der Datei DF.DATA1 flöten gehen würde, da sie die Changes der SCN+40 aus den Redo Logs wiederherstellen können, wenn Sie nicht vergessen, die Redo Logs mit zu backupen. Die oracle instanz würde dann anhand der SCN+40 in der Kontrolldatei und der SCN+39 in der DF.DATA1 erkennen, dass der DF.DATA1 noch Änderungen fehlen, und diese nachziehen.
Schlimm ist allerdings zum einen, dass die Datei DF.DATA2 geändert wird, während wird Sie backupen. DAss dabei nichts anständiges raus kommen kann, sollte Ihnen einleuchten. die Datei könnte korrupt sein, da Sie teilweise Änderungen aus der version SCN+39 und tewileise Änderungen aus der Version SCN+40 enthält, aber nichts Ganzes aus einer der Versionen.
Desweiteren ist es fatal, dass wir die Version SCN+40 der Datei DF.DATA3 sichern würden und nicht die Version SCN+39 der Datei DF.DATA3. Denn unsere Oracle Instanz wird bei einem REcovery-Vesuch mit dem Wert SCN+40 in der Kontrolldatei feststellen, dass die Dateien DF.DATA1 und DF.DATA2 in der version SCn+39 vorliegen und versuchen, aus den Redo Logs die Version SCN+40 herzustellen, jedoch mitunter scheitern, da Teile der Änderungen auch in die Datei DF.DATA3 geschribeen werden müssten, die sich jedcoh bereits auf Version SCN+40 befindet. Oracle wird sich dabei mitunter verwirrt in die Ecke zurückziehen und anfangen zu weinen.
Deswegen müssen Sie bei einem online backup sicherstellen, dass während des Onlien Backups nichts, aber auch gar nichts, in die Datendateien geschrieben wird, sondern alle Änderungen ausschließlich in REdo Logs und Archive Logsg eschrieben werden. Das machen Sie, indem Sie den Tablespace, den Sei backupen wollen, in den BACKUP-Modus versetzen
alter tablespace <tablespacename> begin backup;


# nach dem backup dann

alter tablespace <name> end backup;
In diesem Modus kann kein Checkpoint herbeigeführt werden und alle Änderungen werden nur noch in die Log-Dateien gespeichert. Und hier werden Sie feststellen, dass Änderungen im laufenden Betrieb kein Problem sind.
Gehen wir von folgendem Szenario aus
Gerade werden die Datendateien gesichert. Da der Tabelspace in den backup-modus geschaltgen ist, kann uns während des Backups nieamnd in die Datendateien reinschreiben, diese sind also sicher. Gleichzeitig wird gerade das allererste Redo Log File archiviert, das zweite Redo Log File wartet noch auf Archivierung, da es voll ist, und alle im Moment stattfindenden Changes, etwa der Change 40, wandert in die dritte Redo Log Datei. Solange wird nicht bei der dritten REdo Log Datei angekommen sidn, werden alle Changes einfach ganz problemlos in die dritte Redo Log Datei geschrieben. der kritische Punkt ist erst erreicht, wenn wir die dritte Redo Log Datei sichern wollen, und diese immer noch die aktive Redo-Log-Datei ist, welche die aktuellen Changes aufzeichnet. Dieser kritische punkt ist hier an dieser Stelle erreicht:
Hier kommt Ihnen das Redo Log mirroring zu gute, also die Tatsache, dass pro REdo Log Gruppe zwei Redo Log Dateien vorhanden sind. Wie Sie wissen, wird immer nur maximale eine der beiden Redo Log Dateien in unserer 3. Redo Log Gruppe beschrieben, während von der anderen Redo Log Datei in der 3. Gruppe gelesen wird. Während also eine Datei mit der neuen Änderung 41 gerade beschrieben wird, kann die andere Datei mit der Änderung 40 zurückgesichert werden. Die Änderung 41 ist zwar dann nicht im Backup mit enthalten, aber so ist das nunmal bei einem Online-Backup.
Zu guter letzt müssen Sie sich noch ans Herz legen, dass Sie die Dateien in der richtigen Reihenfolge backupen müssen. Die richtige Reihenfolge zum Backup einer Oracle-Datenbank ist von oben nach unten:
- Datendateien
- Redo Logs
- Archive Logs
- Control Files
denn überlegen Sie mal: Wenn Sie die Kontrolldateien gleich als erstes wegsichern, kann es Ihnen passieren, dass Sie REdo Logs mit der Version SCN+40 zurücksichern, aber eine Control Datei mit der Version SCN+39 im Backup haben. Das heißt, Oracle wird die Änderungen in der Version SCN+40 in den Redo Logs womöglich ignorieren oder Ihnen eine Fehlermeldung ausspcuken, dass die Redo Logs eine neuere Version anzeigen als das Control File. Umgekehrt bekommen Sie aber alle Änderungen aus der Version SCN+40 aus dem Backup heraus, auch wenn Sie zu guter letzt eine Kontrolldatei SCN+41 speichern, da die Datendateien ja eine Version haben, die älter ist als SCN+40 und sich daher die Änderungen aus den Redo Logs holen.
Zudem sollte logisch sein, dass Sie die Redo Logs vor den Archive Logs backupen. Denn wenn Sie erst die Archive Logs backupen und kurz nach dem Backup des Archive Logs wird ein noch nicht im Archive-Log-Backup enthaltenes Redo-Log archiviert und gleich danach geleert, dann wrid das nun leere Redo-Log nicht mehr gebackupt, aber auch die soeben frisch archivierte Version ist nicht in Ihrem Backup enthalten. Umgekehrt passiert es Ihnen allerhöchstens, dass Sie die Version eiens Redo Logs backupen, welches wenig später archiviert wird und dann lediglich doppelt noch einmal im Archive-log-Backup auftaucht.
Was bei Oracle cool ist ist die Tatsache, dass sie unabhängig von dem hier geschilderten Verfahren, welches ein „Full Backup“ umfasst, ein ständig im Hintergrund laufendes Backup haben können, welches zumindest einen Großteil Ihrer Daten sichert. Nehmen wir an, Sie haben eine Datensicherung der Datendateien,m die 30 Tage zurückliegt, auf einem Tertiärspeicher wie beispeilsweise einem Magnetband gesichert. Und Sie konfigurieren, dass jedes mal, wenn ein Redo Log File voll wird, das Archive Log ebenfalls auf einen Tertiärspeicher gesichert wird. Dann müssen Sie nur noch einstellen, dass bei jeder Archivierung eines Redo Logs gleichzeitig das Control File mitgesichert wird, und Sie haben ein autoamtisches, im Hintergrund alufendes Backup aller Daten außer denen, die im aktuellen Redo Log File drin sind. Und dieses Redo Log File wiederum haben Sie ja pro Gruppe gemirrort auf zwei Dateien, so dass Sie hier zumindest schonmal ein sehr einfaches Backup von diesem REdo Log haben. Sie sehen also: Bereits mit relativ wenig Aufwand können Sie Ihre Oracle Datenbank zumindest sehr einfach gehalten irgendwie backupen.
Sie sollten jedoch trotzdem hin und wieder ein Full Backup nach dem oben genannten Verfahren anstoßen, da Sie sich sicher vorstellen können, dass es nach 60, 90 oder 120 Tagen ziemlich lange dauern wird, alle Änderungen seit dem letzten Stand der Datendateien aus den Archive Logs wiederherzustellen.
Seit Oracle 10g steht außerdem die sogenannte Flash-Backup-Technologie zur Verfügung. Richtig kofniguriert schreibt der RKWR-prozess analog zum LGWR-prozess zu jeder nderung, die sich in denn REdo-Log-Dateien befinde,t auch die Undo-Informationen mit. Damit ist es möglich, dass zu einem beliebigen Stand der Datenbank ZURÜCKgerollt werden kann, auch wenn der gewünschte Stand schon mehrere Tage zurückliegt. Stellen Sie sich ein Computerspiel vor, bei welchem eine große Welle an Hackern die Daten von zahlreichen Spielern geknackt und deren Accountdaten verkauft haben. Mit den gesicherten Undo-Informationen könnte der Betreiber die Daten der spieler auf den Zeitpunkt vor den Angriff zurückrollen.
Wenn dir dieser Post gefallen hat, teile ihn doch auf Social Media, abonniere und verfolge mich per E-Mail, RSS-Feed, Social Media oder registriere dich auf meiner Seite. Wenn du registriert bist, like den Post bitte, wenn er dir gefallen hat!]]>
Das ganze bringt natürlich auch leider einige Nachteile. So können Sie das Buch leider nicht weiterverkaufen, weil es mit Ihrem Amazon-Konto verbunden ist.
Amazon liefert Ihnen die Apps zum Lesen von Kindle-Büchern auch dann, wenn Sie selbst nie einen Kindle gekauft haben. Denn Amazon erhofft sich dadurch, dass Sie einen noch besseren Anreiz haben, um das ein oder andere Buch zu kaufen, und erhofft sich dadurch einen Gewinn auch bei Nicht-Kindle-Usern.
Downloaden können Sie die notwendige Software unter http://www.amazon.com/gp/kindle/kcp. Unter Windows klicken Sie einfach auf den Button Download und installieren die KindleforPC-installer.exe. Danach starten Sie die Software und können sich daraufhin mit Ihrem Amazon.de-Account anmelden. Von dort an finden Sie in der Software alle Kindle-Bücher, die mit Ihrem Amazon-Konto verbunden wurden.
Wenn dir dieser Post gefallen hat, teile ihn doch auf Social Media, abonniere und verfolge mich per E-Mail, RSS-Feed, Social Media oder registriere dich auf meiner Seite. Wenn du registriert bist, like den Post bitte, wenn er dir gefallen hat!]]>Dieser Post soll sich mit den softwareseitigen Lösungen auseinandersetzen. Dabei geht es hier nicht nur um Bild+Ton im Allgemeinen, sondern um spezielle Einsatzszenarien.
PC-Audio in Kombination mit Mikrofon aufnehmen
Wenn ihr headset und ihre Soundkarte eine StereoMix funktion hat, können Sie StereoMix als Hardwaregerät in ihren Audiogeräten der Windows-Systemsteuerung finden. Aktivieren Sie StereoMix und weisen eine hörbare Lautstärke zu, senden Sie ab sofort auch das, was Sie hören. Der nachteil: sind Sie mit anderen Perosnen im Gespräch, hören sich diese selbst und ihre gesamten PC-Sounds. Deswegen ist es grundsätzlich empfohlen, auf dedizierte Tools zum Aufnehmen von Sound + Mikrofon zu benutzen, die wir nachher noch vorstlelen werden.
Eventuell unterstützt ihre Hardware zwar StereoMix, jedoch ist die Funktion im Betriebssystem noch nicht eingerichtet oder aktiviert. Dann müssen Sie die Funktion erst noch einrichtne. Gehen Sie dazu in die Systemsteuerung und dann auf die Sound-Einstellungen / Reiter Afunahme / Rechtsklick / Deaktivierte Geräte anzeigen . Die Stereomix-Schnittstelle hat dann Namen wie beispielsweise StereoMix, Waveausgang-Mix oder WASAPI-interface.
Mit aktiviertem STereoMix können Sie dann in einer gewöhnlichen Mikrofon-Aufnahmesoftware wie beispieslweise Audacity dann auf Aufnahme drükcen. Neben dem, was sie ins Mikrofon sprechen, werden nun auch sämtliche hörbaren Geräusche in Ihrem Sytsem mit aufgezeichnet.
Vorteil der StereoMix-Variante: funktioniert immer, egal bei welcher Awnendungssoftware. Wie bereits erwähnt, gibt es aber für spezielle anwnedungsgebiete dedizierte aufnahmesoftware, welche das Aufnehmen von mikrofon und PC-Sound kombiniert erlaubt.
Angeblich soll die software No23 recorder eine gute Möglichkeit sein, anwendungsunabhängig mikrofon + PC-Sound aufzunehmen, ohne dass Gesprächspartner über Skype etc. beispielsweise sich selbst oder ihre PC-Sounds hören. Ich persönlich habe No23 Recorder jedoch bis zum heutigen Tage noch nie auf einem PC zum Laufen bekommen, weil angeblich die Soundkarte die aufnahme nicht unterstützt.
Für die Aufzeichnung von Gesprächen, beispielsweise in Skype oder Microsoft Lync, können Sie auf die Tools aus meinem Post Mitschneiden von Anrufen zurückgreifen.
Ansonsten können Sie die Tools zum Aufnehmen des PC-Desktops, die ich weiter unten vorstelle, benutzen. Diese haben meistens die Möglichkeit, die Sounds über den Lautsprecher und das Mikrofon zunächst getrennt aufzunehmen und dann in einer einzigen Soundspur in das aufgenommene Video zu integrieren. Die Soundspur können Sie dann mit externen Tools aus dem Video rausschneiden. Einige dieser Softwarelösungen bieten sogar die Möglichkeit, den Video-Input gar nicht aufzunehmen und nur den Sound aufzunehmen – was ihnen natürlich entgegenkommen würde.
Die ultimative Lösung ist eine Software namens Virtual Audio Cable. Mit dieser software ist es möglich, PC-Sound von Anwendungen, PC-Sound von Unterhaltungen (etwa über Skype) und ihr mikrofong getrennt aufzunehmen. Führen Sie die Datei vcctlplan.exe aus. Hier machen Sie Einstellungen. Erhöhne Sie die Anzahl der Cables auf zwei. Stellen Sie die Sampling Rate (SR) auf 22050-48000 und die BPS von 8-16, die NC von 1-2. Startne Sie den PC neu. Wenn Sie jetzt in Windows auf die Wiedergabegeräteeinstellungen gehen, sollten Sie zwei Geräte Line 1 und Line 2 haben.
Starten Sie jetzt das programm selbst, also audiorepreater.exe, zweimal. In der ersten isntnaz wählen Sie bei Wave in Line 1 und bei Wave out wählen Sie ihre Lautsprecher. im zweitne wählen Sie bei Wave in Line 2 und bei Wave out wählöen Sie wieder ihre Lautsprecher. Ändern Sie die Total bnuffer-Werte auf von 500 auf 100 und die buffers auf 5. Klicken Sie jetzt in biedne Fenstern auf Start.
gehen Sie jetzt über Rechtsklick Lautstärkeregelung / wiedergabegeräte / reiter Wiedergabe auf Line 1 udn setzen dieses Gerä#t als Standard kommunikations- und Standardgerät. Desweiterne sollten Sie jetzt in ihrer Lautstärkeregelungen im Mixer unter Gerät Line 1 ausgewählt ist und nicht ihre Lautsrpecher.
Jetzt ist ihr Haupt-PC-Sound in Line 1. Jetzt gehen Sie in ihre Konverstationssoftware, also beispielsweise Skype, Lync, Mumble, Ventrilo oder TeamSpeak, gehen auf die Soudneinstellungen und geben als Wiedergabegerät Line 2 an. unter skype beispielsweise tools /options / audio Settings / Speakers / Line 2. Jetzt geht ihr normaler PC Sound über Line 1 raus und ihr Skype-Sound über Line 2.
Jetzt brauchen Sie noch ein Aufnahmeprogramm, mit dem Sie verschiedene Audioquellen getrennt voneinander aufnehmen können, wie beispieslweise Dxtory. oder: Sie starten zwei instanzen einer Aufnahmesoftware, die nur eine Audioquielle aufnehmen kann, und wählen zweimal die verschiedenen Lines aus – und starten zweimal die Aufnahme synchron.
Online-Radio aufnehmen
Das geht ziemlcih einfach mit Tobit Radio.fx. Dieser hat in seiner Datenbank alle großen Online-Radiosender eingepflegt. Einfach den Sender auswählen und eine Aufnahme einstellen. Gute Alternativen sind Noxon Player, StationRipper, TapInRadio, phonostar und ChiliREc.
einen anderen Weg schlägt das Tool radiotracker ein. in diesem suchehn Sie nach einem bestimmten Song. Der radiotracker scannt dann die verfügbare Senderliste nach Sendern, die diesen Song gerade spielen – und Sie können ihn dann aufnehmen.
Wenn Sie einen alternativen Radiosender anhören und aufzeichnen wollen, von dem Sie die URL haben, können Sie das Audio mit der Software RipCast Streaming Audio Ripper aufzeichnen.
Wenn Sie sich einen Winamp-Shoutcast-Stream anhören und diesen Aufzeichnen wollen, können Sie auf das Winamp-Plugin Streamripper zurückgreifen, welches sich in den Winamp integriert.
PC-Desktop aufnehmen
Wenn Sie den Inhalt ihres Desktops aufnehmen wollen (und nicht dne inhalt von Ganzfensteranwendungen wie beispielsweise PC-Games), dann eignen sich Programme wie CamStudio, Camtasia, Windows Media Encoder etc. dafür.
Live-Streaming aufnehmen
Wenn Sie einen Live-Stream auf Ihrem PC laufen haben – beispielsweise einen GAming-Shoutcast, ein Fußballspiel, den Superbowl oder Sonstiges, wollen Sie diesen vielleicht aufzeichnen.
Dabei hat der Streamer jedoch meist ein Interesse daran, das Speichern der Aufzeichnung nicht nativ durch seine Streaming-Website anzubieten – weil er das nicht will oder die Möglichkeiten dazu nicht hat.
Als allererstes sollten Sie sicherstellen, dass die Aufzeichnung des Live-Streams legal ist oder – falls nicht – vom Streamer trotzdem tolleriert wird. Ist diese voraussetzung gegeben, können Sie sich die folgendne Tipps ans Herz legen.
Am schwierigsten sind Streams aufzunehmen, die nur über eine spezielle Website oder eine speizelle Anwendung aufgenommen werden können. eine einfache Möglichkeit, Livestreams aufzunehmen, ist ihren PC-Bildschirm abzufilmen. Sehr einfach geht das mitden oben bereits vorgestellten Tools zur Desktop-Aufzeichnung an ihrem PC. Als Beispiel seien nochmal CamStudio, Debut Video Caputer Software, Windows MEida Encoder, Camtasie, WM MCApture und Daniusoft genannt. Die beste Lösung scheint der windows Meida Encoder zu sein. Die installation läuft einfahc üpber Wizard – die Framerate sollte auf 29.97 FPS und 2400 Kbps gestellt sein. Den Stream jetzt von der beliebigen Quelle im Fenstermodus starten und loslegen.
Einfacher ist es bei Streams, die als URL von einem beliebigen Audioplayer aufgerufen werden können. Versuchen Sie, die URL des Streams im VLC MEdia Player zu öffnen über Media / Open Netowrk Stream. Fügen Sie die Aresse ein und schauen Sie, ob Sie den Stream aufrufen können. Ist das der fall, können Sie unter View / Advanced Options eine Taste einstellen, mit der sie die Aufzeichnung starten können. Danach starten Sie mit der Tastedie Aufzeichnung desStreams. Wenn die richtige URL des Streams hinter ActiveX oder JavaScript versteckt ist, können Sie versuchen, die URL über einen Sniffer wei Wireshark, URL Scooper oder Coojah + Blader heruaszufinden. Man kann dann versuchen, die dort herausgefundene URL im VLC zu öffnen. Für bestimmte Protokolle gibt es auch Bezahlsoftware, die man kaufen kann. Das ist jedoch eigentlich nicht notwendig.
Sie können auch auf die in meinem Hardware-Post genannten Lösungen zurgeifen, um den PC-Bildschirm abzufilmen, wenn Sie das interessiert.
On-Demand-Streaming aufnehmen
Wenn Sie kein Live-Streaming, sondern On-Demand-Streaming aufnehmen wollen, beispielsweise Videos oder Audio von Youtube, gibt es spezielle Softwarelösungen dafür, die darauf spezialisiert sind. Die Software ruft dabei das Streaming-Video selbst auf und fügt die einzelnen temporären Videoteile, die für kurze Zeit auf dem videoaufrufenden PC gespeichert werden, zusammen. Dies ist die qualitativ beste Methode, um gestreamte Videos aufzuzeichnen.
zum einen gibt es Web-Tools, die das ermöglichen – beipsielsweise Keepvid oder FlashVideoDownloader. Zum anderen gibt es Desktop-Software wie biespielsweise DamnVid, File2HD oder Clipgrab. Manchmal helfen auch Browser-Addons wie beipsielsweise der Download Helper für den Firefox. Wenn diese tools einmal versagen, hilft die Software VideoCacheView. Diese listet alle Video- und Audio-Dateien auf, die in den Browsercaches liegen. Man nkann diese dann durchprobieren und schauen, wo das gewünschte Video versteckt ist. Die Datie muss man sich dann nur aus dem Browsercache rauskopieren und umbenennenn.
Gaming-Footage und Vollbild-Videos auf dem PC aufnehmen
Neben dem allseitsbekannten Fraps gibt es noch ein paar Geheimtips, die es sich anzusehen lohnt.
Ein gutes Tool – meiner Meinung nach – ist Dxtory. die PRo-Version kostet 29 englische Pfund.
Wenn Sie Dxtory installiert haben, gehen Sie im dritten Reiter (Ordner-Symbol) auf Choose a Folder und wählen den Ordner aus, in dem die Videodateien gespeichert werden sollen. Klicken Sie auf den schwarzen Kreis, um einen Benchmark durhczuführen und ide schreibgeschwindigkeit auf der Festplatte zu ermitteln. für eine 720p-Aufnahme brauchen Sie eine Festplatte, die minimum 80 MB/s schreiben kann. Um diese Geschwindigkeit zu erreichen, hilft es, eine extra Partition für die Videodateien Ihrer platte anzulegen (oder noch besser: eine extra festplatte zu verwenden) und diese Partition zu defragmentieren.
Die beste Aufnahme-Experience bekommen Sie mit dem Lagarith Lossless Codec, den Sie downloaden und installieren. Wählen Sie dann im fünften Tab (Kamera-Symbol) von Dxtory diesen Codec als Video Codec aus. Gehenj Sie die in ndie Konfiguration des Codecs und wählen Sie als mode YV12 aus. Aktiiveren Sie, falls noch nicht geschehen, die Checkbox Use multithreading, wenn Sie einen Mehrkernprozessor haben. Aktivieren Sie unter Output die Checkbox File Output.
Mit der aktuellen Version des AMD Grafikkartentreibers „Gaming Evolved“ gibt es außerdem die Möglichkeit, das Plays.tv-Feature mitzuinstallieren. Nach der installation des Features kann man einstellen, dass dieses automatisch erkennt, sobald eine Partie in einem der unterstützten GAmes losgeht, und fängt automatisch an zu recorden. Die Performance und Qualität ist dabei durchaus nicht zu verachten.
Der treiber speichert automatisch die gesamten Matches als Videodatei auf eurer Festplatte. mit der tastenkombination Strg+F2 könnt ihr highlights aufzeichnen, die dann als extra-Clips auf eurer platte landen, womit es euch einfacher möglich ist, kleine Clips aufzunehmen, beispielsweise für ein Tutorial-Video oder Ähnliches
Leider eignet sich das Feature nicht, um normalen Desktop-Footage aufzunehmen. Die Software wurde ausschließlich auf ingame-aufnahmen optimiert, was sich meinem Verständnis entzieht, da eine derartig gute Integration in die Grafikkartentreibersoftware auch für gewöhnliche Desktop-Aufnahmen sprechen würde.
Smartphone-Bildschirm aufnehmen
Die beste möglichkeit, um den Bildschirm ihres smartphones aufzunehmen, ist auf dem Smartphone VNC einzurichten und dann von ihrem PC aus mit beispielsweise dem TightVNC Viewer sich afu das Smartphone zu verbinden. Dann können Sie einfach mit den oben vorgestellten lösungen Ihren PC-Desktop abfilmen und Ihr Smartphone bedienen. Alles, was auf dem Smartphone-Bildschirm passiert, wird dann auf dem Desktop des PCs angezeigt und somit mit aufgenommen.
Wenn dir dieser Post gefallen hat, teile ihn doch auf Social Media, abonniere und verfolge mich per E-Mail, RSS-Feed, Social Media oder registriere dich auf meiner Seite. Wenn du registriert bist, like den Post bitte, wenn er dir gefallen hat!]]>Geht außerdem sicher, dass ihr euch meinen Post Portable USB-Stick Apps für Windows anseht, wenn ihr an portabler Stickware interessiert seid.
Gaming
| Software | Erklärung | Alternative |
| HLSW | Serverbrowser, der eigentlihc so gut wie alle Spieler unterstützt. Funktioniert außerhalb des Spiels und hat in der Regel einen höheren Funktionsumfang als integrierte Serverbrowser |
Kommunikation
Gaming-Messenger
| Software | Erklärung | Alternative |
| Uplay | Gaming-Plattform von UbiSoft. Steam-Abklatsch | |
| XFire | Messenger, mit dem das Chatten über Overlay während des Spielens möglich ist. Hält außerdem die Spielzeit fest, die man mit einem Spiel verbringt, und zeigt kontakten an, ob man gerade ingame ist oder nicht. |
Office, Verwaltung und Organisation
| Software | Erklärung | Alternative |
| QR Code Generator | generiert QR-Codes aus Textern, WLAN-Netzen, URLs oder kotnakten. |
Kalender, Timer und Zeitmanagement
Multimedia
Lesen und Konvertieren
| Software | Erklärung | Alternative |
| Adobe Reader Free | Foxit Reader |
Codecs
| Software | Erklärung |
| Advanced Codecs | allumfassendes codec-Pack |
| Standard Codecs für Windows 7/8/10 | Codec-Pack vom Advanced Codecs Macher |
| Codecs für Windows XP and vista | Codec-Pack vom Advanced-codecs-Macher für Windows XP und Vista |
| KLite Mega Codec Pack | gutes Codec Pack für alle Windows-Versionen |
| MediaInfo | zeigt Codec und Videoformat von Videos an |
Audiobearbeitung
Bildbetrachtung, -bearbeitung und Screenshots
Abspielen und Betrachten
| Software | Erklärung | Alternative |
| Aunplayer | Player, der zumindest ältere Blu Rays mit Kopierschutz abspielt. Für neuere (etwa Planet der Affen) braucht man ein kostenpflichtiges Angebot wie beispielsweise WinDVD / PowerDVD. Mit updates könnte es sein, dass auch neuere Versionen abgespielt werden. | |
| stealthy Firefox | Stealthy Chrome | Proxy, der eine andere Herkunft vorschleiert. Dadurch wird das Betrachten von in Deutschalnd zensierten Youtube-Videos möglich. | HideMyAss! |
Umwandeln und Grabben
| Software | erklärung | Alternative |
| XMedia REcode | Umwandler von Audio- und Videodateien, der auf das Umwandeln für Smartphones und Tablets spezialisiert ist. Hat vorgefertigte Profile, mit denen man ein Video so umwandeln kann, dass es auf dem jeweiligen Smartphone garantiert abspielbar ist. | |
| VideoCacheView | für alle Internet-Videos oder Internet-Audiodateien, für die es keinen installierbaren Grabber gibt, gibt es VideoCacheView. Das Tool analysiert alle Videos und Audiodateien, die im Browser-Cache auf dem lokalen Windows-System liegen. Diese kann man dann einzeln durchklicken und schauen, ob das gewünschte Video dabei ist. | |
| ClipGrab | Grabbt automatisch Videos von den Portalen Youtube, MyVideo, DailyMotion, Vimeo und MySpass.de. Wenn es mal nicht mehr geht, muss man einfach ein paar Tage warten und dann die aktualsiierte Version installieren. Kann auch Videos als .mp3-Datei grabben. Unterstützt auch das Grabben kompletter Kanäle. |
Imagen, Rippen und Brennen
| Software | erklärung | Alternative |
| ImgBurn | schlicht und einfach gehaltene Brennsoftware, die jedoch alle wesentlichen Features bietet. | |
| Virtual Clone Drive | Imaging-Software, bei der Image-Dateien von CDs oder DVDs digital eingebunden werden können | |
| Daemon Tools | Imaging-Software, die neben CD- und DVD-images auch Blu Ray Images akzeptiert. Enthält dafür aber oft Adware |
System
Dateioperationen
| Software | Erklärung | Alternative |
| TestDisk & Photorec | TestDisk stellt komplette versehentlich gelöscht oder verloren gegangenen Festplatten-Partitionen wieder her, aber auch versehentlich gelöschte USB-Sticks. Ist gut zur Wiederherstellung schon verloren geglaubter Daten geeignet, beispielsweise wenn eine externe Festplatte versehtnlich formatiert wurde. Je weniger das Medium bereits mit neuen Daten überschrieben wurde, desto besser sind die Erfolgschancen.PtohoRec stellt verloren geglaubte Videos und Fotos von Speicherkarten und Sticks wieder her. Unschlagbares Duo | |
| Eraser | Tool zur dauerhaften Vernichtung von Dateien, so dass diese selbst mit Datenrettungstools nicht mehr wiederhergestellt werden können. Nur für einzelne Dateien und Ordner, nicht für komplette Festplatten geeignet | |
| Recuva | Dient zur Wiederherstellung kürzlich gelöschter Dateien auf einem Windows-System. Wenn nicht wie bei TestDisk eine komplette Partition oder ein komplettes Speichermedium formatiert, sondern nur eine Datei gelöscht wurde, kann man diese mit Recuva wiederherstellen. Je weniger Daten in der Zwischenzeit seit dem Löschvorgang auf das M;edium geschrieben wurden, desto besser die Erfolgschancen. | |
| Roadkils Unstoppable Copier | Wenn man Daten von bereits vorgeschädigten Festplatten oder zerkratzten CDs auf ein unbeschädigtes Medium sichern will, bricht Windows oft den Kopiervorgang ab, weil Fehler beim Lesevorgang auftreten. Der Unstoppable Copier analysiert die Fehler – ist der Fehler nicht kritisch, setzt er den Kopiervorgang fort. Oft die letzte Möglichkeit zur Rettung verlorengeglaubter Daten | |
| TeraCopy | Alternative zum Windows Explorer beim Kopieren und Verschieben von Daten. Fragt nicht so oft nach bzw. ermöglicht es, im vornherein Antworten zu definieren und somit häufiges Nachfragen über das Überschreiben oder behalten von älteren Dateien zu umgehen.Ermöglicht das Pausieren und Wiederaufnehmen von Kopiervorgängen, wenn man die Schreib-/Lesegeschwindigkeit eines Mediums gerade mal für was anderes braucht.Hauptfeature: Ermöglicht das Kopieren von Daten in einer Warteschlange. Wenn man mehrere unterschiedliche Ordner gleichzeitig per Strg+V irgendwo einfügt, wartet Teracopy erst, bis der eine Kopiervorgang abgeschlossen ist, bevor er den nächsten startet. Ist schneller als wenn man alle Daten gleichzeitig kopiert. | |
| RichCopy | Kopiertool, welchesauf das schnelle Kopieren von vielen kleinen Einzeldateien spezialsiiert ist. | |
| WinSCP | Tool, welches das Kopieren von Dateien über SCP per grafischer Oberfläche ermöglicht. Einfach SSH-Logindaten des entfernten Rechners eingeben und die gewünschte Datei im Dateibaum des Zielrechners platzieren. |
Cloud-Dateisharingdienste
| Software | Erklärung |
| Dropbox | bekanntester Cloudsharingdienst |
| Microsoft OneDrive | Nachfolger von SkyDrive. 7 GB freier Speicherplatz. |
| Google Drive | Google cloudsharingdienst |
Treiber
| Software | Erklärung | Alternative |
| DriverBackup! | einfaches Tool zum Sichern, Wiederherstellen und Entfernen | |
| DoubleDriver | analysiert die Treiber auf Ihrem System – welche sind vorhanden, sind diese noch aktuell? Und sie können von den Treibern ein Backup durchführen | Device Driver Backup |
| DriverPack Solution | Enthält vier GByte an aktuellen treibern und prgorammen zur Aktualsiierung eines Systems. Zeigt die passenden Treiber für das System an und aktualsiiert sie bei Bedarf. | |
| Driver Sweeper | entfernt Reste von alten, nicht mehr genutzten Treibern. | |
| Driver Booster Free | überprüft, ob die aktuell installierten Treiber auf dem neuesten Stand sind und aktualisiert diese auf Wunsch automatisch. |
Updates und Runtimes
| WinFuture Update Pack | Enthält alle für ein beliebiges windows-System relevanten Microsoft-Updates, die mit einem mal heruntergeladen und installiert werden können. Keine lästige Neustart- und Download-Orgie über das integrierte Windows Update mehr |
| All In One Runtimes | Enthält fast alle wichtigen Laufzeitumgebungen, die für den Betrieb von Software nötig sind: .NET frameworks, Direct X 9 Zusatztdateien, Java, Adobe Flash player, Visual C++, Adobe shockwave, silverlight. |
| Adobe AIR | Laufzeitumgebung, die im All In One-Pack leider nicht enthalten ist, aber für viele Programme gebraucht wird. |
| DirectX Webinstaller | Installiert automatisch die aktuelle Multimedia-Komponente von DirectX |
| Mozilla Shumway | Alternative zum Adobe Flash Player für den Firefox. Sorgt für Flash-Unterstützung per JavaScript |
| Chip Updater | kontrolliert die installierte Software auf dem Windows-PC nach Updates und hilft beim herunterladen oder automatischen Updaten, je nach Programm. |
| SEcunia Personal Software Inspector | kontrolliert die installierte Software auf dem Windows-PC nach Updates und hilft beim herunterladen oder automatischen Updaten, je nach Programm. |
| UpdateStar | kontrolliert die installierte Software auf dem Windows-PC nach Updates und hilft beim herunterladen oder automatischen Updaten, je nach Programm. |
| FileHippo Update Checker | kontrolliert die installierte Software auf dem Windows-PC nach Updates und hilft beim herunterladen oder automatischen Updaten, je nach Programm. |
Hardware, Performance und Benchmarking
| Software | Erklärung | Alternative |
| LinPack | Kommandozeilen-Benchmark für CPU-Leistung | |
| Whetstone | CPU Benchmark | |
| Dhrystone | CPU Benchmark | |
| SPEC | bieten kostenpflcihtige Benchmark-Lösungen an | |
| CPU-Z | liefert infos über Prozessore, Cache, Mainboard und RAM | |
| Everest HomeEdition | Systemanalyse Tool mit infos zum System und zur Hardware sowie Benchmarking-Tools | |
| SiSoft Andara Lite | Systemanalyse Tool mit infos zum System und zur Hardware sowie Benchmarking-Tools | |
| 3D Mark 2013 | grafischer Benchmark | |
| GPU-Z | zeigt Infos über die Grafikkarte an | |
| Rivatuner | Freeware-Tweaking-Utility für Grafikkarten | |
| Prime95 | CPU-Benchmark durch Primzahlenbrerfdechnung | |
| FurMark | 3D-Benchmark über openGL | |
| HWMonitor | Temperatur, Spannung und lüfter im Auge behalten | |
| SIW | Systemanalyse Tool mit infos zum System und zur Hardware sowie Benchmarking-Tools | |
| aIDA64 | Systemanalyse Tool mit infos zum System und zur Hardware sowie Benchmarking-Tools | AIDA32 |
| Cinebench | 3D Benchmark | |
| Speccy | Systemanalyse Tool mit infos zum System und zur Hardware sowie Benchmarking-Tools | |
| Everest Ultimate | Systemanalyse Tool mit infos zum System und zur Hardware sowie Benchmarking-Tools | |
| CrystalDiskMark | Benchmark für lese-/Schreibgeschwindighkeit von Festplatten | |
| Dr. Hardware 2014 | zeigt viele infomrationen zur HArdware an | |
| 3DMark 11 | DirectX11-Benchmark für Grafiksystem | |
| HeavyLoad | Stresstest für RAm, Festplatte, GraKa oder CPU | |
| 3DMArk06 | der meistgenutzte 3D-Benchmark | |
| HWiNFO64 | Diagnosetool für 64 Bit Systeme | HWInfo32 |
| PC Wizard | Systemanalysetool | |
| OCCT | STabilitätsprüfung | |
| Heaven Benchmark | 3D-Benchamrk | |
| Open Hardware monitor | Liest Werte der Hardware aus und stellt sie grafisch dar | |
| Win Experience Index | Bring twindows Leistungsindex unter Windows 8.1 und Windows 10 zurückj | |
| PCMark 8 | Grafik- und Benchmark-Tool | |
| PCMark 7 | ||
| 3DMark Vantage | ||
| NetStress | testet WLAN-Netz auf Unreglemäßigkeiten | |
| ATTO disk Benchmark | testet Lese- und SChreibgeschwindigkeit von Festplatten | |
| HD tach | festplattenbenchmark | |
| Valley Benchmark | ||
| novaBench | ||
| Blackmagic Disk Speed Test | Festplattenbenchmark | |
| StressMyPC | ||
| Super PI Mod | ||
| CHIP System-Check Tool | ||
| HDD Speed Test 1.0 | ||
| MemTest86 | ||
| Argus monitor | Überwachen der Temperatur von Hardware-Kompoennten | |
| Hot CPU tester | Testet Systemstabilität | |
| DNS Bench | Hilft biem Finden eines schnellen DNS-Servers | |
| CWsysInfo | ||
| Nero DiscSpeed | Laufwerk-Benchmark | |
| M0ooo System Monitor | ||
| FutureMark SystemInfo | ||
| MaxxMEM2 | ||
| eVGA OC Scanner | Grafikkarten-Benchmark für Nvidia Karten | |
| ShaderMark | DirectX9.0c Benchmark | |
| System Spec | ||
| AdvancedRemoteInfo | ||
| GPU caps Viewer | ||
| BootRacer | Misst bootzeit des Rechners | |
| HDSpeed | ||
| GeekBench | ||
| IOmeter | ||
| wPrime | ||
| RAMMon | ||
| RightMark Audio Analyzer | ||
| TamoSoft Throughput Check | ||
| intel Procesor Diagnostic tool for UEFI | ||
| BATexpert | ||
| RAMExpert | ||
| Opt Drive Control | ||
Software-Tuning und -Reinigung
| Software | Erklärung | Alternative |
| CCleaner | ||
| TFC Temp File Cleaner | ||
| TuneUp Utilities | ||
| RegCleaner | Registry Cleaner für Windows 95 bis Windows XP. Für neuere Systeme nicht mehr geeignet. | |
| jv16 Power Tools | Nachfolger des RegCleaners frü 30 Dollar ab windows 2000 und aufwärts bis Windows 8. Reinigt neben Registry nun auch 0-Byte-Dateien, Temp-Dateien, Cookies, Histories und bietet tools zum Überwahcen des Netzwerks sowie ein kleines Backup-tool | |
| Eusing Free Registry Cleaner | Freeware Registry Cleaner für Windows 98 bis Windows 8 | Wise Registry Cleaner |
| Ultimate Process Killer | zeigt alle im System laufenden Prozesse an und liefert infomrationen dazu. Kann auf Wunsch jeden beliebigen Prozess stoppen und die ausführende Datei auf Wunsch gleich löschen. Vorsicht bei der Benutzung. Keine wichtigen Systemprozesse abschließen. | |
| KillProcess | Bessere Alternative zum Windows Task Manager, weil man beispielsweise mehrere zusammengehörige Prozesse gleichzeitig beenden kann. | |
| FreePCAudit |
Systeminformation
Systemadministration
Überwachung und Sicherheit
| Software | Erklärung | Alternative |
| regshot | ermöglicht das Vergleichen von verschiedenen Ständen der Windows-registry. So fallen unerwünschte Änderungen gleich auf. | |
| SysTracer | legt ein Update der Systemumgebung an und kann somit Änderungen am System feststellen, die unerwünscht im Dateisystem oder in der Registry durchgeführt wurden. | |
| Whatpulse |
Anti-Spyware / -Malware
| Software | Erklärung | Alternative |
| Spybot Search and Destroy | ||
| Super Anti Spyware Free | ||
| ESET online Scanner | ||
| Security Check | ||
| Rkill | ||
| MalwareBytes Anti-Malware | ||
| HiJackThis | ||
| McAfee Stinger |
Anti-Adware
| Software | Erklärung | Alternative |
| AdwCleaner | ||
| Toolbar Cleaner | ||
| Ad-Aware Free | ||
| Junkware Removal Tool | ||
| Spyware Blaster | ||
| Unchecky | entfernt automatisch die häkchen zru installation von adware in setuproutinen |
Anti-Rootkit
| Software | Erklärung | Alternative |
| mrb.exe | ||
| OTM by oldTimer | ||
| OTC by oldTimer | ||
| rogueKiller | ||
| ComboFix | ||
| TDSSkiller | ||
| Defogger | Deaktiviert sämtliche virtuellen Laufwerke auf einem PC. Ist notwendig, um das Ergebnis eines rootkit-Scans mit den oben genannten Tools nicht zu verfälschen. |
Wenn dir dieser Post gefallen hat, teile ihn doch auf Social Media, abonniere und verfolge mich per E-Mail, RSS-Feed, Social Media oder registriere dich auf meiner Seite. Wenn du registriert bist, like den Post bitte, wenn er dir gefallen hat!]]>