Kategorie-Archiv: Serveradministration

Linux Shell Skripting Tutorial

Grundlagen

Mit Linux Shell Skripting könne Shell-Befehle automatisiert ausgeführt werden. Ich persönlich gehe davon aus, dass Sie grundsätzlich schon einmal auf einer Linux-Shell unterwegs waren und deshalb schon von den grundlegenden Kommandos etwas gehört haben, wie beispielsweise cat, grep, ls usw., und auch mit einem TExteditor wie vi oder nano schon zu tun hatten.

Skripte sind Dateien, die man bestenfalls mit der Endung .sh abspeichert, damit sie als Shell-Skripte deutlich erkennbar sind. Solche DAteien kann man von jedem Ordner aus ausführen (egal in welchem print working direcotry man sich gerade befindet), wenn man diese in einem Pfad ablegt, der in der PATH-Variable hinterlegt ist (die PATH-Variable enthält Ordner, in denen die Shell automatisch nach Binaries wie grep, ls oder cat sucht. Befindet sich dort ein Skript, wird es gefunden und kann ausgeführt werden, ohne dass man den vollen Pfad zum Skript angeben muss).

Neben Skriptdateien werden in der Unix/Linux-Welt zur Automatisierung von Aufgaben häufig auch Programmiersprachen wie Ruby, Python oder – am beliebtesten – Perl verwendet. In einem anderen Post habe ich versucht zu erörtern, welche Sprache denn in welchen Situationen zur Automatisierung besser geeignet ist – ein  Perl-Programm oder ein Shell-Skript.

Damit diese Dateien überhaupt ausgeführt werden können, müssen in den chmod-Dateiberechtigungen für den User, der die Datie ausführt, Ausführrechte vergeben werden.

chmod u+x <skript>

Skripte werden ausgeführt mit

sh <skriptdatei>

#oder

bash <skriptdatei>

#oder 

zsh <skriptdatei>

#oder

csh <skriptdatei>

oder, wenn die sogenannte Shebang-Zeile gepflegt ist (siehe weiter unten), indem man einfach nur die Datei ausführt

mein_skript.sh

jenachdem, mit welcher Shell man das Skript ausführen möchte. Die beiden häufisgten Shells sind bash und sh. Die meisten Skripte solltet ihr mit der bash ausführen, da die meisten Skripte speziell für die bash geschrieben werden.

Wenn ein Skript fehlerhaft geschrieben wird und es nicht sauber durchläuft, sieht man leider erstmal nicht, warum. Damit man eventuelle Fehlermeldungen beim Ausführen eines Skripts sieht, muss man den PArameter -x mitgeben, also bspw.

bash -x <skriptdatei>

Am Anfang eines Shell-skritps gibt man an, mit welcher Shell man es ausführen möchte. Dazu schriebt amn in die erste Zeile

#!/bin/bash

Dies ist die sogenannte Shebang-Zeile. Damit ist sichegrestellt, dass egal mit welcher Shell man das skript ausführt, am Ende doch die richitge Shell genutzt wird. Selbst wenn ich dieses skript jetzt mit

csh mein_skript.sh

ausführe, wird am Ende doch die bash verwendet. ist die Shebang-Zeile gepflegt, kann man das Skript einfach nur über den Dateinamen ausführen.

Wenn Sie schon mal gurndsätzlich mit einer Unix/Linux-Shell gearbeitet haben, wird Ihnen bekantn sein, dass Sie mit dem kommando export <variablenname> Variablen setzen und über echo $<variablenname> den Wert der Variablen ausgeben können. Solche Variablen sind wichtig für das SEtzen von if else-STatements, also „Wenn dies dann mach das, wenn das andere dann mach jenes“-Verzweigungen in einem Skript.

unsere erste Verzweigung

if [[ $USER = "dafrk" ]]

    then

         echo "Hallo DaFRK"

    else

         echo "Du bist nicht DaFRK"

fi

If-Statements im Shlel-Skripting werden also mit dem Wort if und der Bedingung in doppelten eckigen klammern eingeleitet und mit fi geschlossen.

Die doppelten Eckigen Klammern werden genutzt, wenn man Zeichenketten testen möchte. Möchte man hingegen numerische Werte abfragen, also Zahlen, dann nutzt man doppelte runde Klammenr

if (( $ALTER >= 18 ))

    then

        echo "Zugriff erteilt"

    else

        echo "Sie sind noch nicht alt genug"

fi

Wenn wir dazwischen jetzt nochmal eine KOnditionsabfrage machen wollen, geben wir ein

if (( $ALTER >= 18 ))

    then

        echo "Zugriff erteilt"

      elif (($ALTER <=18 && $ALTER >= 16))

       then

        echo "Zwar noch keine 18, aber ist ja      nicht mehr lange :)"

      else

        echo "Sie sind noch nicht alt genug"

fi

Wichtig ist hier zu verstehen, dass man für das elif wieder ein then braucht, aber es kein schließendes file (elif rückwärts) gibt.
Code Snippets und Skeleton files mit vi

Linux Shell Skripting Tutorial weiterlesen →

Wenn dir dieser Post gefallen hat, teile ihn doch auf Social Media, abonniere und verfolge mich per E-Mail, RSS-Feed, Social Media oder registriere dich auf meiner Seite. Wenn du registriert bist, like den Post bitte, wenn er dir gefallen hat!

Festplatten unter Windows und Linux gleichzeitig nutzen

Es gibt verschiedene Szenarien, in denen Sie eine Festplatte sowohl unter Windows als auch unter Linux nutzen wollen. Beispiel 1: Sie haben auf Ihrem PC ein Dual Boot System eingerichtet, auf welchem sowohl Windows als auch Linux installiert sind und Sie hin und wieder das betriebssyste, mit welchem Sie arbeiten, wechseln

Beispiel 2: Sie befüllen eine externe Festplatte auf einem Windows- oder Linux-Desktop-Rechner, wollen diese aber danach auf einem Server im Netzwerk freigeben, der das jeweils andere Betriebssystem nutzt.

Welches Dateisystem soll die festplatte bekommen?

Die erste Frage, die Sie sich stellen ist: Mit welchem Dateisystem soll ich die Festplatte formatieren? Ist es besser, ein windowsnahes Dateisystem wie NTFS oder exFAT zu benutzen, oder ein linuxnahes Dateisystem wie ext4?

Meine Antwort zu dieser Problematik: Wenn Sie eine externe Festplatte abwechselnd an einem Windows und Linux Desktop Rechner nutzen wollen, dann nehmen Sie ein windows-nahes Dateisystem. Wenn Sie die Festplatte hingegen im Netzwerk auf einem Server hosten wollen, dann nehmen Sie das Dateisystem, welches dem Server am nächsten ist, sprich: bei einem Windows-Server NTFS oder exFAT, bei Linux ext4 oder ext3.

auf Linux Rechner Festplatten größer 2 TB mounten über GPT Partitionstabelle

Wenn Sie Ihre Festplatte mit einer Kapazität von mehr als 2 TB auf einem Linux-System einbinden wollen, müssen Sie zudem sicher stellen, dass die Festplatte, die Sie verwenden, mit einer GPT-Partitionierungstabelle formatiert wird. Denn eine alte MBR-Partitionstabelle unterstützt standardmäßig nur Festplatten mit maximal 2 TB.

Am besten ist es, Sie richten die GPT-Partitionstabelle ein, bevor Sie die Festplatte zum ersten Mal mit Daten befüllen.

prüfen, ob eine Festplatte bereits eine GPT Partitionstabelle hat

unter Windows starten Sie eine eingabeaufforderung als Administrator und geben ein

C:\Windows\system32>diskpart

diskpart>list disk

In der Ausgabe des kommandos list disk sollte es in der Spalte GPT in der Zeile der betreffenden Festplatte ein Kreuz geben. Ist dieses nicht vorhanden, ist die Platte noch MBR.

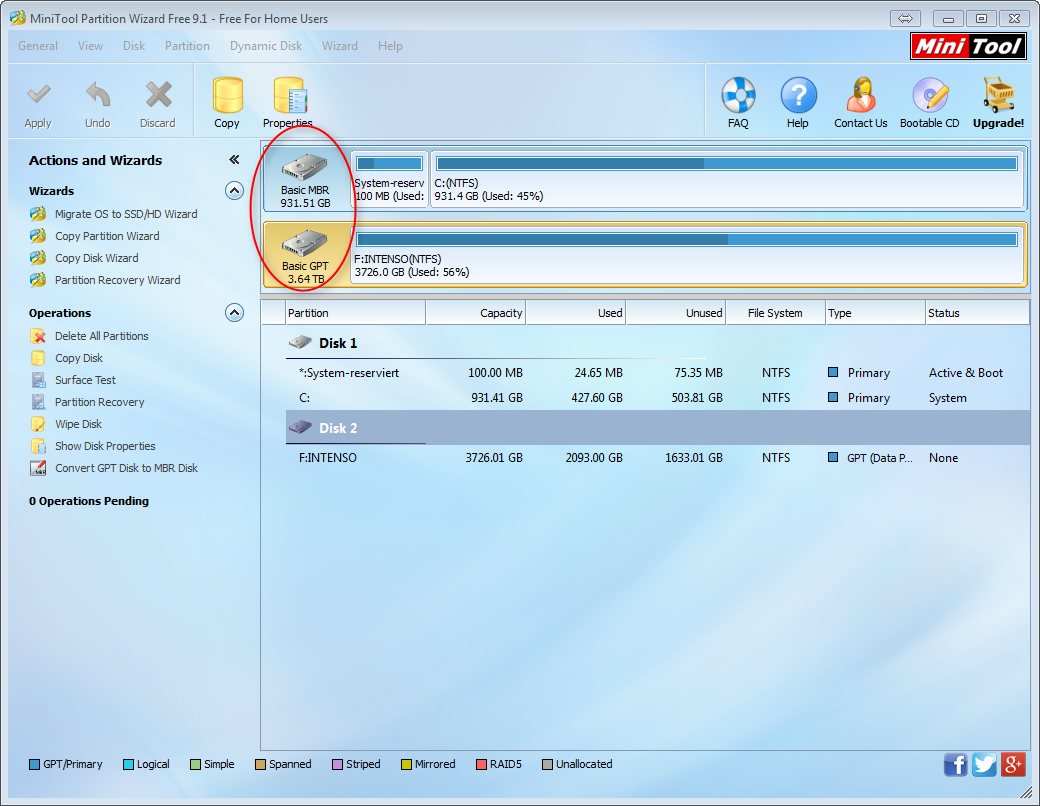
Alternativ zeigt ihnen das Tool MiniTool Partition Wizard Free an, ob die Festplatte mit MBR oder GPT intitialisiert wurde.

2016-02-07_18h03_52

Unter Linux hingegen nutzen Sie das kommando

parted -l

Sie bekommen einen Output, dessen erste Zeilen so aussehen

Model: ATA TOSHIBA THNSNS25 (scsi)

Disk /dev/sda: 256GB

Sector size (logical/physical): 512B/512B

Partition Table: msdos

Der für sie interessante Eintrag ist fett markiert. Steht an dieser Stelle msdos, ist die Festplatte noch mit einer MBR-Partitionstabelle initialisiert. Ansonsten würde hier gpt stehen.

 GPT frisch unter Windows einrichten

Wenn Sei die Festplatte unter Windows formatieren, stecken Sie die Festplatte am Windows-Rechner an. Wir gehen in diesem Szenario davon aus, dass Ihre Festplatte keine produktiven Daten enthält. Wenn Sie eine Festplatte konvertieren wollen, die wichtige Daten enthält (sie die Festplatte also nicht formatierne wollen), dann befassen wir uns damit weiter unten. In diesem Szenario löschen Sie, falls vorhanden, alle existierenden Partitionen auf der fesplatte über die Windows-Datenträgerverwaltung. Rechtsklicken Sie dazu auf das Volume und wählen Sie Volume löschen.

Danach ist ihre festplatte in einem Zustand, in welchem Sie die Platte erst neu initialisieren müssen. Wählen Sie Datenträger initialisieren. Sie werden gefragt, welche Partitionstabelle der Datenträger nutzen soll. Wählen Sie GPT.

Festplatten unter Windows und Linux gleichzeitig nutzen weiterlesen →

Wenn dir dieser Post gefallen hat, teile ihn doch auf Social Media, abonniere und verfolge mich per E-Mail, RSS-Feed, Social Media oder registriere dich auf meiner Seite. Wenn du registriert bist, like den Post bitte, wenn er dir gefallen hat!

Windows SMB/CIFS Freigabe unter Linux mounten

Haben Sie in Ihrem Heimnetzwerk einen Linux Server, auf dem Sie eine Windows-Freigabe von einem Windows-Rechner einhängen möchten, um auf dem Server auf die Daten zugreifen zu können?

Oder haben sie in ihrem Unternehmen Linux-Systeme, die auf Freigaben innerhalb Ihrer Microsoft Windows Active Directory-Struktur zugreifen müssen (beispielsweise um Backups abzulegen)?

Dann ist dieser Post genau der Richtige für Sie. Wenn Sie hingegen wissen wollen, wie Sie auf einem Linux Server Dateifreigaben einrichten, die man dann an einem Windows Client einbinden kann, schauen Sie sich meinen post über Samba an.

Als installieren wir uns auf dem Linux-System benötigte Pakete

apt-get install cifs-utils

Dann erstellen wir das Verzeichnis, in welches die Windows Freigabe später gemountet werden soll

mkdir /windowsfreigabe

Im ersten Szenario werden wir eine Windows Freigabe mounten, die nicht durch Benutzer/Passwort geschützt ist, also Gast-Freigaben, auf die jeder zugreifen kann.

Dann editieren wir einfach nur unsere /etc/fstab und fügen am Ende folgende Zeile ein

//<hostname oder ip-adresse windows freigabeserver>/<Freigabename>  /windowsfreigabe  cifs  guest,uid=1000,iocharset=utf8  0  0

Bei jedem Neustart wird die Freigabe automatisch gemountet, wenn ihr sie ohne Neustart gleich mounten wollt gebt ihr einfach ein

mount -a

Nun wollen wir mal eine Windows-Freigabe mounten, die durch Benuztername und Passwort geschützt ist. Der einfachste, aber nicht unbedingt sichere WEg ist der, dass man den Eintrag in der /etc/fstab so abändert

//<hostname oder IP Windows Freigabeserver>/<Freigabename>  /windowsfreigabe  cifs  username=<windows username>,password=<windows passwort>,iocharset=utf8,sec=ntlm

DAs ist jedoch ein Sicherheitsriskiko, da jeder Benutzer auf der Linux-Kiste die /etc/fstab und somit das Passwort lesen kann.

Stattdessen erstellen wir also im Homeverzeichnis des Users, der als einziger in diesem Linux System auf die Freigabe zugreifen können soll, eine Datei ~/.smbcredentials und schreiben dort folgendes rein:

username=<windows username>

password=<windows passwort>

Dann ändern wir die Berechtigungen der Datei

chown <linux user, der zugreifen soll> ~/.symbcredentials

chmod 600 ~/.smbcredentials

Dann bearbeiten wir unseren Eintrag in der /etc/fstab folgendermaßen:

//<hostanem oder ip windows freigabeserver>/<freigabename> /windowsfreigabe cifs credentials=/home/<username>/.smbcredentials,iocharset=utf8,sec=ntlm 0 0


Wenn dir dieser Post gefallen hat, teile ihn doch auf Social Media, abonniere und verfolge mich per E-Mail, RSS-Feed, Social Media oder registriere dich auf meiner Seite. Wenn du registriert bist, like den Post bitte, wenn er dir gefallen hat!

Dateiübertragungen und -kopien verifizieren mit Checksummen

Hier ein kurzer Post der beschreibt, wie man beim Übertragen von Dateien von einem Ort zum anderen schnell sicherstellen kann, dass die File Contents gleich sind

Haben die beiden Ordner die selbe Größe?

Erstmal, bevor ihr genauer analysiert, wollt ihr überhaupt wissen, ob zwei Ordner, die ihr an zwei STellen kopiert habt, ungefähr die selbe Größe haben. DAs lässt sich  über du -sh rausfinden

du -sh /somedir

du -sh /newdir

Die Checksumme bei unterschiedlichen Verzeichnissen

Szenario: Ihr habt zwei Verzeichnisse, die einen anderen PFad haben, in dem sich aber die selben Dateien befinden. Eine Version der Dateistruktur habt ihr unter /somedir und die andere unter /newdir

Im Folgenden gehen wir davon aus, dass wir eine ganzes Verzeichnis mit mehreren Unterordnern kopiert haben, beispielsweise über einen Befehl wie

cp -rpf /somedir/* /newdir

Wir wollen jetzt natürlich sichergehen, dass in newdir wirklich alles aus somedir angekommen ist. ES wäre viel zu aufwändig, jede einzelne Datei zu checksummen und zu vergleichen. Daher bedinene wir uns einem kommando im Format

find -s /somedir -type f -exec md5sum {} \; | cut -d" " -f1 | md5sum

und vergleichen die Checksumme von somedir mit der Checksumme von newdir

find -s /newdir -type f -exec md5sum {} \; | cut -d" " -f1 | md5sum

Zusätzlich zur Checksumme solltet ihr noch grob die Größe der beiden Verzeichniss emiteinander vergleichen.

Die Checksumme bei gleichen Verzeichnissen

Ihr habt auf zwei Systemen verschiedene Dateien im selben Verzeichnis.

find /somedir -xdev -type f -print0 | LC_COLLATE=C sort -z | xargs -0 cat | md5sum -

Und das ander prüft ihr entsprechend gleich auf dem anderen System

find /somedir -xdev -type f -print0 | LC_COLLATE=C sort -z | xargs -0 cat | md5sum -

Downloads verifizieren

Wenn Sie sich Dateien von einem Webserver oder einer sonstigen Quelle herunterladen, veröffentlichen findige administratoren zusätzlich zum Download immer die Checksumme, die der Veröffentlicher des Downloads zuvor festgestellt hat. Sie als Downloadender prüfen dann die checksumme des Veröffentlichers mit der checksumme, die Sie bei Ihrer gedownloadeten Datei bekommen. somit können Sie feststellen, ob entweder beim Download Übertragungsfehler vorgekommen sind und die datei in einem fehlerhaften Zustand heruntergeladen wurde, oder ob vielleicht sogar jemand ohne Wissen des Veröffentlichers die zum Herunterladen angebotene Datei verändert und manipuliert hat, um beispielsweise einen Virus einzuschleusen.

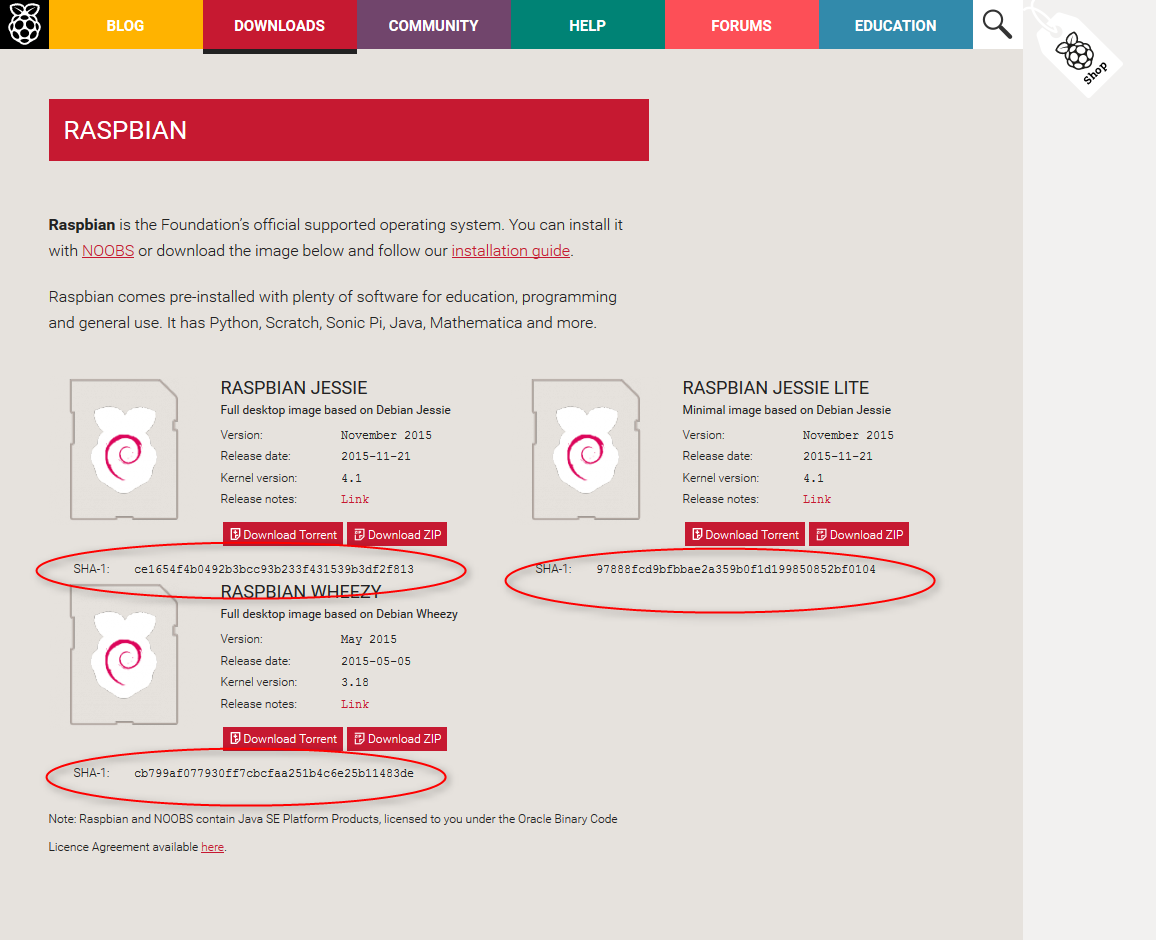
Der Veröffentlicher von Downloads nutzt verschiedene kanäle, um Ihnen seine checksumme bereitzustellen. Einige schreiben die checksumme auf der Seite, auf der die datei heruntergeladen wird, hin. so passiert das Beispielsweise beim Downloaden von Images für den raspberry pi.

2016-01-30_15h13_53

wie sie sehen wird auf der Website vom Raspberry pi die Art der checksumme, in diesem Fall SHA-1, und danach die checksumme selbst, angezeigt. sie als Downloader müssen nur wissen, welchen Befehl Sie auf Ihre heruntergeladene Datei für welche Art von Checksumme ausführen müssen. Die gängigsten Befehle und arten sind:

  • der Befehl md5sum für MD5-Checksummen
  • der Befehl sha1sum für SHA-1 Checksummen
  • cksum für CRC32-Checksummen

Da es sich auf der Website um eine SHA-1Checksumme handelt, können Sie Ihre eigene checksumme rauskriegen über

sha1sum <Datei>

vergleichen Sie nun Ihre Checksumme mit der checksumme auf der Website. Unterscheiden sich diese, würde ich zuerst versuchen, die Datei erneut herunterzuladen. Unterscheidet Sie sich auch beim zweiten Mal, wurde sie womöglich manipuliert und ich würde sie nicht öffnen bzw. verwenden.

Andere Veröffentlicher von Downloads speichern die Checksumme in eine Datei, die dem Download beiliegt. somit können sie auch noch Jahre später, nachdem die Datei womöglich gar nicht mehr zum Download angeboten wird, noch prüfen, ob diese noch korrekt ist. Wenn Sie selbst eine Datei zum Download anbieten und die checksumme in eine Datei schreiben wollen, können Sie beispielsweise eine MD5 Checksumme über


md5sum <datei> > checksumme.txt

reinschreiben. Diese Datei bieten Sie dann entweder extra zum Download an, oder Sie packen den ursprünglichen Download und diese Textdatei nochmal in ein extra Archiv, beispielsweise ein .zip oder .rar-archiv, und bieten dann dieses zum Download an.

Wichtig für den Downloader ist dann, dass der nicht die Checksumme dieses Archivs, in dem die checksummen Datei mit drin ist, testet, sondern den eigentlichen Download testet. Wenn Sie etwa eine .rar-Datei downloaden, in der sich eine weitere .rar-Datei mit dem eigentlichen Download und eine Datei mit der Checksumme befindet, dann testen Sie  nicht die äußere .rar-Datei, sondern die .rar-Datei vom eigentlichen Download, da nur auf diese die Checksumme passt.

Sie können die checksumme entweder selber vergleichen, indem Sie einmal in die datei und einmal auf die ausgabe des md5sum-Befehls schauen, oder sie lassen md5sum den Vergleiche machen über

md5sum -c < checksumme.txt

Damit das geht, müssen Sie im Verzeichnis sein, in welchem sich die Datei befindet, deren Checksumme mit der Checksumme in der Datei checksumme.txt zusammenpassen soll.

Umständlich wird dies, wenn Sie die checksummen mehrere Dateien, also beispielswiese von einem ganzen ordner, vergleichen wollen. Wie Sie selbst checksummen von ganzen Ordnern erstellen und diese an einer anderen Stelle vergleichen, habe ich Ihnen wieter oben schon gezeigt. Wenn Sie jedoch einen ganzen Ordner zum Download anbieten oder einen solchen herunterladen, bieteet es sich an, die CRC32-checksummen aller Dateien in einem ordner in eine .sfv-Datei schreiben. .sfv steht für Simple File Verification. Als Veröffentlicher erstellen Sie eine .sfv-Datei mit den Checksummen aller Dateien in einem ordner über die Software QuickSFV, die es sowohl für Windows als auch Linux gibt. Der Downloader kann dann diese .sfv-datei mit dem gleichen Tool öffnen und schauen, ob die Dateien in seinem heruntergeladenen Ordner mit den Checksummen in der .sfv-Datei übereinstimmen.

Wenn dir dieser Post gefallen hat, teile ihn doch auf Social Media, abonniere und verfolge mich per E-Mail, RSS-Feed, Social Media oder registriere dich auf meiner Seite. Wenn du registriert bist, like den Post bitte, wenn er dir gefallen hat!

Daten aus Datenbanken, SQL, JSON, XML und Flat Files extrahieren und umwandeln

Als Systemadministrator oder Entwickler kommen Sie irgendwann an die Herausforderung, mit Daten umzugehen, die in verschiedenen Formaten vorliegen. Teilweise als Flat File, also beispielsweise als .csv-Datei, die über Microsoft Excel gepflegt wurde, teilweise als .xml-Datei, und teilweise müssen Sie Daten aus einer datenbank extrahieren, um sie in eine andere Datenbank zu laden oder in eine .csv- bzw. xml-Datei zu exportieren. Und einige Datenbanken bieten die Funktion zum Exportieren der Daten in eine Datei mit SQL Statements, aus der Quelltabelle in einer neuen Datenbank wieder aufgebaut werden kann.

In diesem Beitrag, der regelmäßig aktualisiert wird, zeige ich Ihnen, wie Sie daten von verschiedenen Datenbankmanagementsystemen in SQL Statements Files, Flat Files oder .xml-Files exportieren und umgekehrt aus diesen Dateien auch wieder in die Datnebank importieren. Desweiteren zeige ich IHnen, wie Sie .xml-Files in Flat Files und umgekehrt Flat Files in .xml-Files konvertieren.

Das extrahieren von Daten aus einer Quelle, das Umwandeln in ein Zwischenformat und das Laden der Daten in ein Ziel wird auch als Extract, Transform and Load (ETL) bezeichnet.

Datenbanken

In diesem Abschnitt befassen wir uns damit, wie wir Daten aus einzelnen Tabellen einer Datenbank exportieren können. Ich zeige Ihnen hier, wie Sie die Daten aus einer oder mehreren Tabellen der Datenbank in ein Flat File und in SQL-Statement-File bekommen und wie Sie die Tabelle in einer anderen Datenbank aus dem SQL Statement File wieder aufbauen können. Desweiteren zeige ich Ihenn, wie Sie eine bstehende Tabelle aus einem beliebiegn Flat File  befüllen und aufbauen.

SAP HANA

Daten von der Datenbank in ein Flat File oder SQL Statement File exportieren

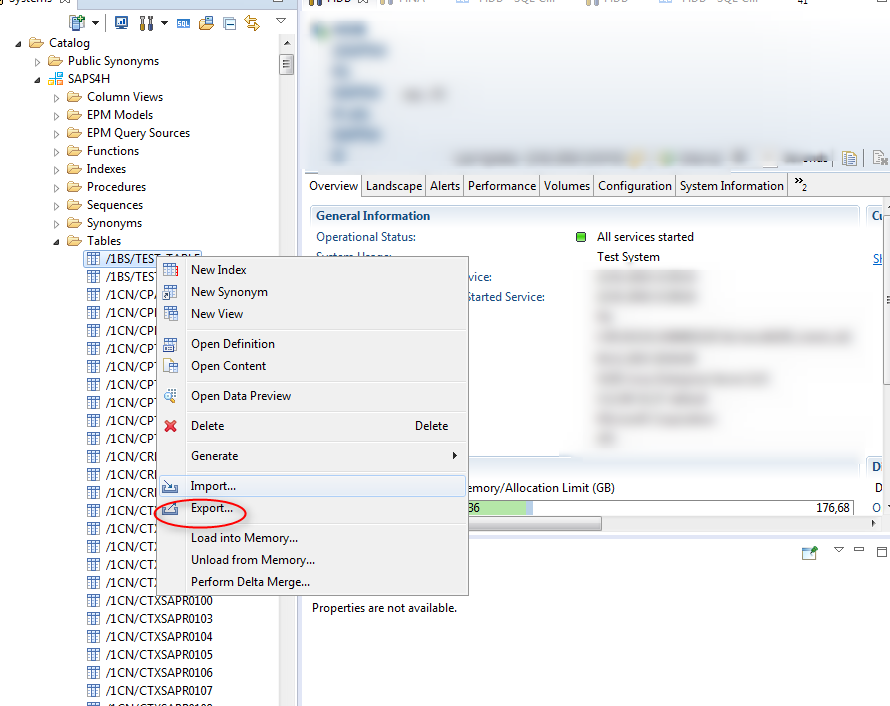
die einfachste Möglihckeit, DAten aus einer SAP HANA datenbank zu exportieren, ist es,  die gewünschte Tabelle im HANA Studio unter Catalog -> <Schema Name> – Tables auszuwählen und damm im kontextmenü auf Export zu gehen.

2016-01-23_23h47_44


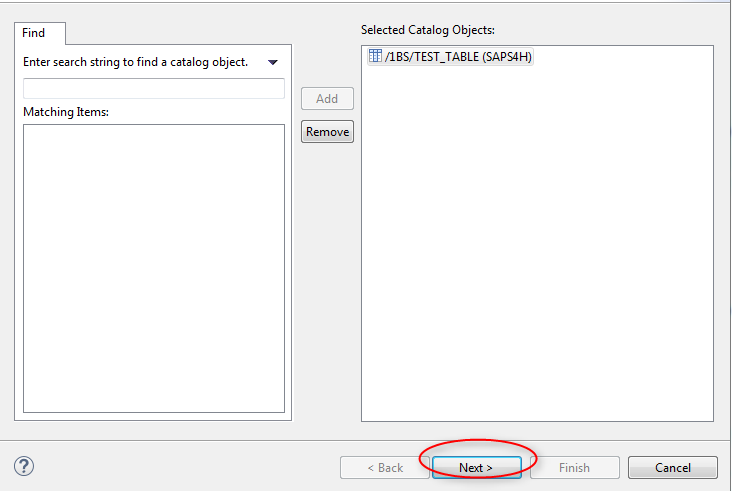
Im nächstne FEnster können Sie mehere Tabellen hinzufügen. Haben Sie alle gewünschten objekte selektiert, wählen Sie die Schaltfläche NExt.

2016-01-23_23h50_22

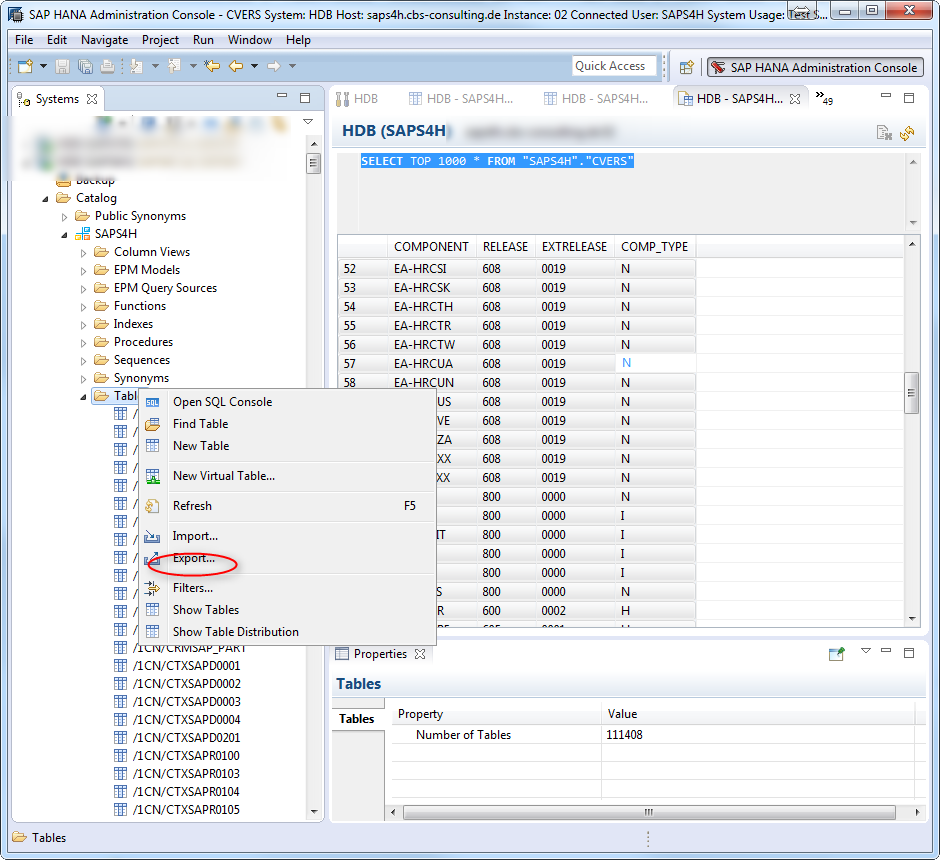
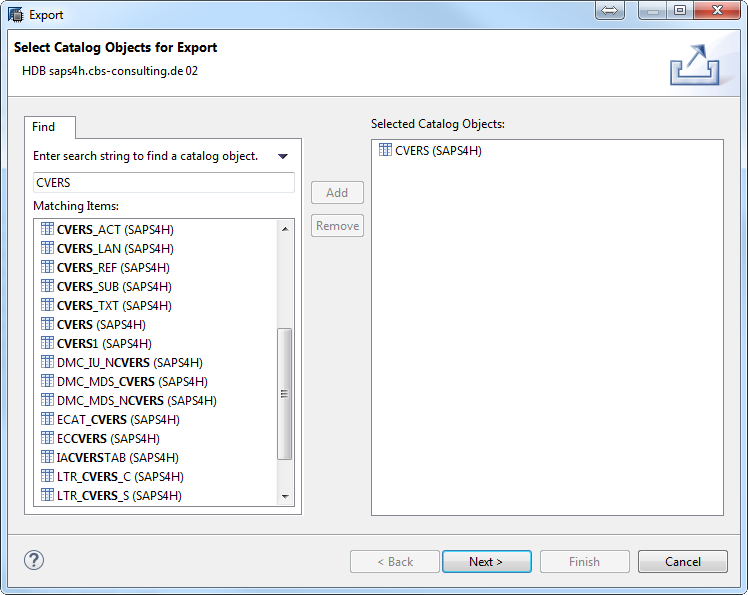
Alternativ können Sie auch bei TAbles im kontextmenü Export wählen und dort dann die Tabelle suchen und hinzufügen

2016-01-23_23h57_34

2016-01-23_23h58_33

Die Daten können Sie nun entweder als BINARY oder als CSV-DAtei exportieren. Egal was Sie hier wählen, Sie exportieren auf diesem Weg nur die MEtadaten über die Tabelle. Das heißt Sie bekommen eine sogenannte create.sql, mit deren Hilfe Sie die Tabelle in einer anderen Datenabnke wieder erstellen können (jedoch ohne daten darin) sowe eine .xml-Datei, welche die Metadaten nochmal extra ausschildert.

Daten aus Datenbanken, SQL, JSON, XML und Flat Files extrahieren und umwandeln weiterlesen →

Wenn dir dieser Post gefallen hat, teile ihn doch auf Social Media, abonniere und verfolge mich per E-Mail, RSS-Feed, Social Media oder registriere dich auf meiner Seite. Wenn du registriert bist, like den Post bitte, wenn er dir gefallen hat!

Textoperationen für Systemadministratoren (Linux Shell Tools, Texteditoren, Microsoft Excel)

Als Systemadministrator haben Sie es oft mit TExtdaten zu tun, die Sie auf irgendeine Art und Weise verarbeiten oder sortieren müssen. Dabei kämpfen Sie an allen Fronten: in der Windows- oder Linux-Kommandozeile, mit Microsoft Excel und mit simplen Texteditoren – seien es Linux/Unix-Shelleditroen wie vi, vim oder nano oder grafische Windows-Editoren wie Notepad, Wordpad oder Notepad++. Und zu guter letzt vergleichen Sie noch unterschiedliche Versionen einer Textdatei auf Unterschiede und fügen diese Unterschiede zusammen.

In diesem Blogpost zeige ich Ihnen anhand einiger Situationen aus meinem Administrationsalltag, wie Sie verschiedene Herausforderungen mit Hilfe von Kommandozeilen- und Shell-Kommandos, Microsoft Excel und den TExteditoren vi (Linux) und Notepad++ (Windows) lösen können. Der Post wird aktualisiert, sobald mir irgendwann wieder eine neue Situation begegnet, an der ich feilen muss.

Die Linux-Textverarbeitungstools auf Shell-Ebene

Den output von kommandos in Skripten loggen

Wenn ihr unter Linux ein Skript, etwa in Form einer .sh-Datei, schreibt, ist es euch vielleicht schonmla passiert, dass euer Skript nicht durch gelaufen, also auf einen Fehler gestoßen, ist. Zur Fehlersuche machen sich viele die Mühe und führen die einzelnen kommandos einen nach dem anderen aus, was jedoch absolut unnötig ist.

Stattdessen könnt ihr das Skript ausführen mit

sh -x <Skriptdatei>

bzw. 

bash -x <Skriptdatei>

und euch wird der Output eurer kommandos angezeigt.

Und ihr könnt sogar, ohne das Skript live bie der Ausführung zu beobachten, den Output der Kommandos loggen. Dabei empfiehlt es sich, normalen Output in eine Datei, und Fehlermeldungen in eine sepzielle andere Datei zu loggen. Dazu würde ich einfach an das kommadno anhängen

sh -x <SkriptDatei> > normal.log 2> error.log

somit wird der normale Output der Skript-Kommandos in die Datei normal.log geschrieben und alle Fehlermeldungen in die Datei error.log. Wenn ihr nun eure Skriptdatei beispielsweise über die /etc/crontab so einplant, könnt ihr euch am nächsten Tag, wenn euer skript nicht sauber durchgelaufen ist, ansehen, warum das passiert ist. Dabei muss euch bewusst sein, dass die einfahcen >-Zeichen dafür sorgen, dass die Datei jedesmal überschrieben wird, wenn die Log-Datei neu befüllt wird, das heißt die alten Einträge verschwinden dann. WEnn ihr stattdessen die Einträge jedesmal an den aktuellen Inhalt einfach nur dranhängen wollt (ohne den alten zu überschrieben), müsst ihr statt einem > zwei hintereinander schreiben, also

sh -x <SkriptDatei> >> normal.log 2>> error.log

Was meine persönlich preferierte einstellung ist, mit dem Kommando date füge ich dann jedesmal, wenn das Skript läuft, einen aktuellen Zietstempel hinzu, damit ich später unterscheiden kann, welcher Log-Abschnitt zu welchem TAg gehört.

Wenn du mit Absicht verhindern möchtest, dass du versehentlich DAteien überschreibst, indem du in deinen Skripten statt zwei > nur einen > schreibst, dann kannst ud dies verhindern, indem du in der Shell den Befehl

set -o noclobber

wirfst. Von nun an kannst du Dateien nicht mehr mit einem > überschreiben, es sei denn du schreibst ab sofort >| oder stellst den Parameter wieder um über

set +o noclobber

Ich persönlich setze diesen Parameter immer wenn ich Skripte schreibe oder manuell mit Dateien auf der Kommandozeile rumspiele, zur Sicherheit.

Daten suchen und extrahieren

Textoperationen für Systemadministratoren (Linux Shell Tools, Texteditoren, Microsoft Excel) weiterlesen →

Wenn dir dieser Post gefallen hat, teile ihn doch auf Social Media, abonniere und verfolge mich per E-Mail, RSS-Feed, Social Media oder registriere dich auf meiner Seite. Wenn du registriert bist, like den Post bitte, wenn er dir gefallen hat!

Reguläre Ausdrücke auf Kommandozeilen und in Programmiersprachen

Reguläre Ausdrücke (regular ExpressionS) sind eigentlich eine gute Erfindung. Denn: Sie erlauben das Suchen nach oder Ersetzen von  Zeichenketten abhängig von bestimmten TExtmustern. So könnten Sie beispielsweise in einer Textdatei ganz einfach nach einem GEburtsdatum suchen, indem Sie nach einer Zeichenkette aus zwei Zahlen, einem Punkt, weiteren zwei Zahlen, einem Punkt und abschließend 2 oder auch vier Zahlen suchen. So ein Suchmuster ist nur dank regulärer Ausdrücke möglich. REguläre Ausdrücke sind eine echte PAin in the Ass. Denn: Sie sind nicht überall gleich. Je nachdem, ob Sie reguläre Ausdrücke in dieser (z. B. JavaScript) oder jener (z. B. Perl) Skript- bzw. Programmiersprache nutzen wollen oder auf der Linux-Shell oder Windows Power Shell arbeiten, sind sie immer etwas unterschiedlich. Denn die Implementierung regulärer Ausdrücke ist nicht genormt, die Implementierung hängt also einzig allein vom Bereitsteller der Funktionalität ab.

Dieser Post, der regelmäßig geupdatet wird, soll sammeln, wie man reguläre Ausdrücke auf verschiedenen Kommandozeilen, Skript- und Programmiersprachen verwendet.

Aktuell beinahltet der Post nur Grundlagen, die überall gelten, und spezifische Hinweise für die Linux Shell. Mit der Ziet werde ich noch Hinweise für die Windows PowerShell, Windows cmd und für verschiedene Programmiersprachen hinzufügen.

Reguläre Ausdrücke – Grundlagen

die folgenden Grundlagen funktionieren (Gott sei DAnk) in allen Implementierungen von regulären Ausdrücken. So konnte sich zumindest teilweise eine kleine STandardisierung von regulären Ausdrücken durchsetzen.

^ Zeichenketten beginnen mit

Mit dem Zirkumflex können Sie überall nach Zeichenketten suchen, mit einem bestimmten String beginnen sollen. Sie können beispielsweise sagen, ich möchte in einer datei alle Zeilen haben, die mit einer Raute (#) beginnen. Unter Linux würden Sie dazu das  komamndo grep verwenden

grep ^# <datei>

einige Anwendender grübeln immer bei der Frage: „was ist, wenn ich nach einer Zeichenkette suchen möchte, die mit einem Leerzeichen afange?“. DAfür liefern reguläre Ausdrücke entsprehcende Platzhalter, beispielsweise können Sie das folgendermaßen abfragen.

egrep '^\s' <datei>

Das ganze können Sie noch weiter stricken. Was ist denn jeztt, wenn wir wollen, dass sowohl Zeilen, die mit einem Leerzeicehn beginnen, als auch Zeilen, die mit einer Raute beginnen, ausgegeben werden? Nun, dafür bieten reguläre Ausdrücke den Oder-Operator |, sodass wir folgendermaßen arbeiten könnten.

egrep '^\s|^#' <datei>

Leere Zeilen, die nur einen Carriage Return (also einen Zeilenumbruch) enthalten, findet man mit

grep ^$ <datei>

das Dollar steht hier entsprechend stellvertretend für einen Zeilenumbruch.In der Praxis möchte man jedoch meist genua das Gegenteil, also alle Zeilen außer die LEerzeilen finden, daher verwendet amn in der Praxis häufig

grep -v ^$ <datei>

Sie können auch andere sogenannte non-printing characters auf diese Art und Weise finden. Wenn Sie erst wissen müssen, welches Ziechen für den von Ihnen gesuchten non-printing-character steht, können Sie diesen rausfinden über

cat -vet <datei>

Der non printing character wird dann mit dem Zeichen dargestellt, mit dem er in regular Expressions vertreten wird.

^ außerhalb von [] ist nicht das selbe wie innerhalb von [^]

während ein Zirkumflex außerhalb von eckigen Klammern bedeutet, „suche nach Zeichenketten die mit damit beginnen: “ sagt ein Zirkumflex innerhlab von eckigen klammern „Suche nach allem außer dem, was in den eckigen Klammern steht“. [^a-z] sucht also nach allem, was keine Kleinbuchstaben von a-z hat.

$ Zeilen enden mit

Jetzt da wir wissen, dass das Dollar-Zeichen für einen Zeilenumbruch steht, können wir mit

grep .$ <datei>

sagen, wir wollen alles auswählen, was mit einem Punkt aufhört, wenn danach eine neue Zeile beginnt. Wir können also nach Zeilenenden suchen.

Zeichenketten mit einem einzigen Zeichen einer bestimmten Art an einer bestimmten STelle

Was ist, wenn ich aus einer Datei nun alle Zeilen mit Worten mit c<irgendein Buchstbae>t haben möchte, also z. B. cat, cUt, ctt, cOt usw.?

Hierfür gibt es den Punkt. Unter Linux könntet ihr beispielswiese nach einer derartigen Zeichenkette wieder suchen mit

grep "c.t" <datei>

Was nun aber, wenn ihr beispielsweise wollt, dass zwischen c und t nur Vokale stehen dürfen? Damit würden wir noch Zeichenketten mit cat und cut, aber keine mehr mit ctt, cdt o. Ä. erwischen. In disem Fall könnt ihr eine sogenannte Range an Zeichen, die in die Zeichenkette passen dürfen, angeben.

grep "c[aeiou]t" <datei>

Wenn ihr hingeen wollt, dass alle Buchstaben von A-P an der STelle sein dürfen, womit Zeichenketten wie cat, cpt, cot, ckt, cbt etc. ausgewählt werden würden, könntet ihr angeben:

grep "c[a-p]t" <datei>

Im Moment wählen wir aber nur  Kleinbuchstbaen aus. wEnn wir auch Großbuchstaben auswählen wollen, müssen wir mit dem Oder-Operator (|) arbeiten und sagen

grep "c[a-pA-P]|" <datei>

Damit werden nun auch die Großbuchstaben A-P ausgewählt.

Was ist nun, wenn ihr nach Ziffern in einer Datei suchen wollt? In diesem Fall würden wir sagen

grep "[0-9]" <datei>

Und wenn es statt einstelligen Ziffern nur dreistellige Zahlen sein dürfen (100, 101, 199, 200, 999 etc.), dann schreiben wir

grep "[0-9][0-9][0-9]" <datei>

Statt solcher Ranges kann man auch Klassen angeben

  • [[:alpha:]] ist das selbe wie [a-zA-Z]
  • [[:upper:]] ist das selbe wie [A-Z]
  • [[:lower:]] ist das selbe wie [a-z]
  • [[:digit:]] ist das slebe wie [0-9]
  • [[:alnum:]] ist das selbe wie [0-9a-zA-Z]
  • [[:space:]] wählt alle White Spaces, also bspw. Leerzeichen oder Tabstopps, aus.
  • [[:punct:]] wählt alle Sonderzeichen aus, also !"#$%&'()*+,
    \-./:;<=>?@
    [\\\]^_`{|}~]
  • weitere Klasen findet ihr unter http://www.regular-expressions.info/posixbrackets.html

und statt dieser Klassen kann man man auch Abkürzungen schreiben wie beispielswiese

  • \d  ist das selbe wie [0-9]
  • \w ist das selbe wie [0-9a-zA-Z_] (hier ist also der Unterstrich dabei)
  • \s wählt nicht nur Whitespaces (Leerzeciehn und Tabstopps), sondern auch neue Zeilenumbrüche (\n), Zeilenrücksprungmarkierungen (carriage return,\n) und Seitenumbrüche (\f) aus. Achtung: Das ist NICHT das selbe wie [[:space:]]. [[:space:]] kümmert sich NUR und ausschließlich um Whitespaces, also Leerstellen und Tabstopps, \s kümmert sich AUSSERDEM um non-printing-characters, also um Zeichen, die man bei der Ausgbae des Dokuments nicht sieht.

Wenn diese Abkürzungen (Abbreviations) groß geschrieben werden, sucht man nach Zeichenketten, die nicht diese Zeichenketten enthalten.. /D sucht also nach allen Zeichenketten, die keine Ziffer enthalten. [^0-9]

Reguläre Ausdrücke auf Kommandozeilen und in Programmiersprachen weiterlesen →

Wenn dir dieser Post gefallen hat, teile ihn doch auf Social Media, abonniere und verfolge mich per E-Mail, RSS-Feed, Social Media oder registriere dich auf meiner Seite. Wenn du registriert bist, like den Post bitte, wenn er dir gefallen hat!

Funk- und USB-Steckdosen Fernsteuern mit dem Raspberry Pi

die Hardware

Sie brauchen


die USB-STeckdosenleiste fernsteuern

Als erstes lernen wir, wie wir die Gembird (m)SiS-PM STeckdosenleste unter Linux steuern. Dazu installieren wir auf unserem Raspberry Pi erstmal dfie Bibliothek libusb-dev

sudo apt-get install libusb-dev

Danach können wir das Tool sispmctl runterladen und kompilieren, welches für das eigentliche Steuern der Steckdose notwendig ist. Den atkeullen Dwonload-Link bekomt ihr unter http://sispmctl.sourceforge.net/.

tar xzvf sispm_ctl--3.1..tar.gz

cd sispm_ctl-*

 ./configure

make

sudo make install
Prüfen, ob die Software sauber installiert wurde.
which sispmctl
Daraufhin muss der Pfad zur sispmctl-binary angezeigt werden. Ist das der Fall, wurde das tool sauber installiert. Jetzt steckt ihr die USB-Steckdosenleiste per USB an den RAspberry Pi. und in eine Steckdose. LEgt nun den Schalter an der Steckdosenleiste um, so dass sie eingeschaltet ist. Es leuchten nun an vier der Steckdosen LEDs die anzeigen, dass alle vier dieser Steckdosen eingeschaltet sind. Die beiden anderen STeckdosen in de rLeiste lassen sich nicht manuell ein und ausschalten, sondenr sind immer an.
Nun wollen wir mal die Steckdose mit der Nummer 1 ausschalten. Das geht mit
sudo sispmctl -f 1
Die LED bei der Steckdose mt der Nummer 1 müsste jetzt soeben ausgegangen sein.
Nun wollen wir die Steckdose mit der Nummer 1 wieder anschalten, das geht mit
sudo sispmctl -o 1
Nun wisst ihr, wie ihr mit der Kommandozeile  die STeckdosen aus- und einschaltet. Als Zusatz gibt es noch ein Webinterface – d. h., ihr könnt die einzelnen STeckdosen der Leiste auch über den Browser abschalten. dAzu schaltet ihr das Webinterface mittels.
sudo sispmctl -i 0.0.0.0 -p 8989 -l
Nun könnt ihr auf eurem Browser das Webinterface starten über
http://<ip oder hostname raspberry pi>:8989
Nun zu guter letzt zeige ich euch noch ein Beispiel, wie ihr einzelne Steckdosen der Leiste zeitgesteuert ausschalten lassen könnt. Dazu müsst ihr euch eine .sh-Datei erstellen, beispielsweise unter /home/pi/steckdose_aus.sh. Diese kann beispielsweise den Inhalt haben
sudo sispmctl -f 1
Das heißt, diese Skriptdatei wird später die erste Steckdose der Leiste ausschalten.
Nun editiert ihr mit dem Editor vi die Datei /etc/crontab. Nehmen wir an ich möchte, dass jeden Tag um 01:00 Uhr morgens die Steckdose 1 der Leiste automatisch abgeschalten wird. DAnn hänge ich ganz am Schluss der Datei eine Zeile an mit
0 1 * * * pi sh -x /home/pi/steckdose_aus.sh
wenn ich jetzt den cron-Daemon neu starte über
/etc/init.d/cron restart
dann wird die neue Zeile jeden Tag um 1 Uhr ausgeführt. und diese Zeile startet eben unser Skript steckdose_aus.sh.
Wenn ich jetzt möchte, dass jeden Tag um 09:00 Uhr die Steckdose wieder an geht, schreibe ich mir eine zweite Datei steckdose_an.sh und mache das gleiche nochmal.

Die Funksteckdosen fernsteuern

 Verbinden der Komponenten

mit den STeckbrücken verbinden Sie den Ground-Pin des GPIO-Anschlusses (PIN 6) mit dem letzten PIN des Sendemoduls. Den Daten-PIn des Sendemoduls schließen Sie an PIN 17 der GPIO schnittstlele an, Power an PIN Nummer 4. An den Antennen-PIN des Sendemouls stecken Sie einfach nur eine Steckbrücke an ohne dieses am anderen Ende irgendwo anders anzustecken.

Wenn man das funksendemodel also mit der CMOS-Batterie nach oben hält und die vier Pins von links nach rechts mit 1-4 beschriftet, dann wird so angeschlossen

Sendemodul PIN 1 GPIO 6
Sendemodul PIN 2 GPIO 17
Sendemodul PIN 3 GPIO 4
Sendemodul PIN 4 leeres Jumperkabel

Nun müssen noch die Jumper auf der Rückseite der Steckdose richtig gesetzt werden.

Jumper Position
1 oben
2 unten
3 oben
4 unten
5 oben
A siehe unten
B siehe unten
C siehe unten
D siehe unten
E unten

Bei A-D müssen Sie pro Steckdose immer einen der vier Jumper auf die Stellung oben stellen, alle anderen bleiben unten. Damit ist es Ihnen möglich, die einzelnen Steckdosen getrennt voneiannder an- oder auszuschalten. Wenn Sie natürlich alle Steckdosen zusammen an- oder ausschalten wollen, dann stellen Sie bie allen drei Steckdosen den gleichen Jumper nach oben. Der Jumper-Code unserer STeckdose wäre, wenn wir den Jumper A anch oben stellen, 1, beim Jumper B nach oben 2, bei Jumper C 3 und bei Jumper D 4.

Die Jumper 1-5 sind Ihr sogenannter Home-Code. Dieser soll verhindern, dass Sie mit dem Raspberry Pi oder mit der Steckdose versehentlich einen Steckdosensatz mit einem anderen Home-code (etwa vom Nachbarn) steuern. Der home-Code unseres STeckdosensatzes wä#re also in diesem Beispiel 10101.

Grundinstallation

apt-get install git-core

git clone git://git.drogon.net/wiringPi

cd wiringPi/

./build

cd ..

git clone git://github.com/xkonni/raspberry-remote.git

cd raspberry-remote/

make send

Funk- und USB-Steckdosen Fernsteuern mit dem Raspberry Pi weiterlesen →

Wenn dir dieser Post gefallen hat, teile ihn doch auf Social Media, abonniere und verfolge mich per E-Mail, RSS-Feed, Social Media oder registriere dich auf meiner Seite. Wenn du registriert bist, like den Post bitte, wenn er dir gefallen hat!

Raspberry Pi Skripte über Weboberfläche und Smartphone App ausführen

In meiner neuen Blogkategorie Raspberry Pi sammle ich interessante Projekte für zu Hause und allgemein für die IT-Administration, die mit dem Raspberry Pi zu tun haben. Beispielsweise habe ich Ihnen vor einigen Tagen gezeigt, wie Sie Ihren Raspberry Pi als Netzwerkkamera oder auch als Multi-Room-HiFi-Station nutzen. Es folgen noch Beiträge zum Fernsteuern von Beleuchtung, Stromversorgung (Steckdosen), Rollläden, Garagentore und Fenstern.

Wenn Sie dranbleiben und irgendwann all meine Projekte durchgearbeitet haben, werden Sie sich irgendwann die Frage stelllen, wie Sie denn simpel und einfach die einzelnen Funktionen, die Sie nun implementiert haben, von einem einzigen Gerät aus, beispielswiese einer Fernbedienung, steuern. Es hat ja durchaus seinen Reiz, wenn man allein mit einer Fernbedienung sein gesamtes Haus fernsteuern kann. Welches Geräte wäre dafür besser geeignet als Ihr Smartphone?

falls Sie noch kein Projekt für den Raspberry Pi implementiert haben, empfehle ich Ihnen, erstmal das in Angriff zu nehmen. Eine Fernsteurung des Raspberry Pip über das Smartphone macht schließlich erst dann Sinn. Sie sollten den Raspberry Pi dann auch fertig eingerichtet haben, wie in meinem Post einen Raspberry Pi einrichten – So geht’s erklärt.

Ist Ihr Pi dann bereit, müssen Sie erstmal das Software Repository hinzufügen, um raspctl später herunterladen und installieren zu können. Dazu fügen wir erst den GnuPG Key des Entwicklers hinzu und dann das Repository selbst.

Raspberry Pi Skripte über Weboberfläche und Smartphone App ausführen weiterlesen →

Wenn dir dieser Post gefallen hat, teile ihn doch auf Social Media, abonniere und verfolge mich per E-Mail, RSS-Feed, Social Media oder registriere dich auf meiner Seite. Wenn du registriert bist, like den Post bitte, wenn er dir gefallen hat!

DynDNS auf Ubuntu Server oder Raspberry Pi einrichten

Dieser Post dient für zahlreiche Tutorials, in denen es Sinn macht, einen DynDNS-Hostnamen auf die IP-Adresse eines Gerätes zu verweisen, als Grundlage.

Wenn Sie nicht ständig die öffentliche IP-Adresse des Gerätes eingeben wollen, welches Sie über das Internet erreichen wollen, sondern lieber einen Hostnamen wie beispielsweise meinraspberry.dyndns.org eingeben wollen, dann müssen Sie einen entsprechenden DynDNS-Hostnamen bei einem Anbieter solcher Hostnames buchen. Die Hostnamen sind kostenlos, bedürfen allerdings einer Registrierung für den Service per E-Mail. Der Hostname wird dann in der Domain des Anbieters eingerichtet, also wäre im Beispiel oben der hostname meinraspberry in der Domain dyndns.org registriert sein, der dann auf die öffentliche IP-Adresse Ihres Heimnetzwerks verweist.

Sobald Sie sich bei einem solchen Dienstleister registriert haben, können Sie meist bereits in Ihrem DSL-Router DynDNS einrichten. Denn wenn beispielswiese Ihr SErver oder Ihr Raspberry Pi in einem lokalen Netzwerk steht, dann haben diese Geräte die selbe öffentliche IP-Adresse wie der DSL-Router – der router kümmet sich dann um die Weiterleitung der Pakete zum Endgerät, also beispielsweise dem Raspberry Pi – über NAT/PAT. Bei der Fritz!Box richten Sie Ihren DynDNS hostnamen beispielsweise unter dem Menüpunkt internet / Freigaben / Dynamic DNS ein. Dort wählen Sie dann den Anbieter, geben Ihren Hostnamen sowie das Passwort für den Account ein. Von nun aktualisiert der DSL-Router jedes mal, wenn sich die öffentliche IP-Adresse ändert, den entsprechenden Wert des Hostnamens, so dass dieser immer auf die aktuelle Adresse verweist.

Wenn Sie jedoch einen Light-Tarif von Ihrem DSL-Provider haben, bekommen Sie häufig Billig-Router, die eine solche DynDNS-Einrichtung nicht unterstützen. In diesem Fall müssen Sie die Aktualisierung der IP-Adresse, auf die der Hostname verweist, direkt auf dem Server vornehmen. Das zeige ich Ihnen jetzt am Beispiel des Anbieters ddns.net.

DynDNS auf Linux Server einrichten

Es empfiehlt sich zunächst (ist allerdings nicht immer notwendig), den Hostnamen des Systems auf den Hostnamen beim DynDNS-Anbieter umzustellen.

als erstes ändern wir den Hostnamen einmla in der Datei /etc/hostname, dann evtl. noch in der /etc/hosts und am Schlus snoch per Befehl

hostname <name>

Geben Sie nur den Hostnamen, also z. B. meinraspberry, ein. Nicht den sogenannten FQDN, also meinraspberry.dyndns.org, das ist falsch.

für den Fall, dass wir das DynDNS auf dem Server selbst einrichten, müssen wir einen DynDNS Client auf dem System installieren. DAfür eignet sich ddclient

sudo apt-get install ddclient

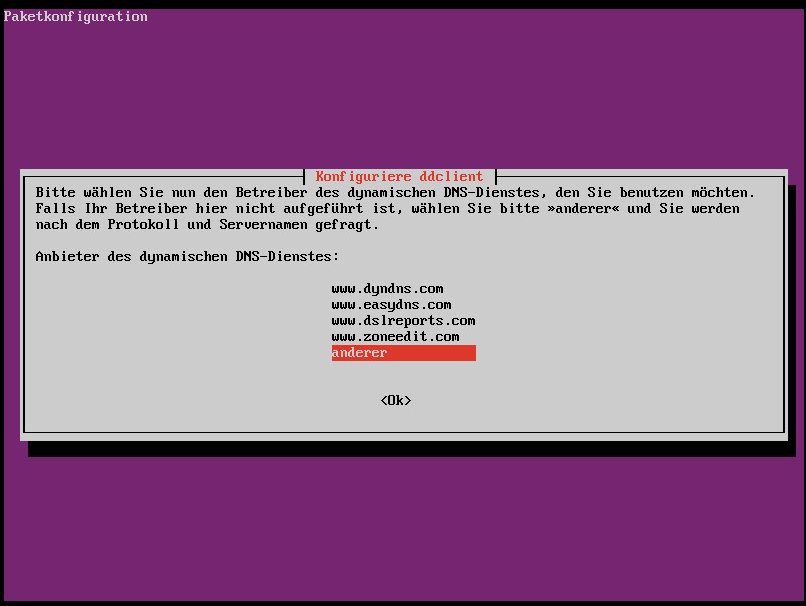
Wärhend der Installation wird man nun gefragt, bei welchem Anbieter man sich registriert hat. In der STandardauswahl ist der Anbieter no-ip.org leider nicht vorhanden, weswegen wir auf ianderer gehen.

2015-04-19_16h09_35

Als server geben wir ein ip1.dynupdate.no-ip.com, als Protokoll dyndns2, als Schnittstelle eth0 und bei vollständigem DynDNS-Domainnamen als beispiel meinraspberry.ddns,net.

DynDNS auf Ubuntu Server oder Raspberry Pi einrichten weiterlesen →

Wenn dir dieser Post gefallen hat, teile ihn doch auf Social Media, abonniere und verfolge mich per E-Mail, RSS-Feed, Social Media oder registriere dich auf meiner Seite. Wenn du registriert bist, like den Post bitte, wenn er dir gefallen hat!